
Der Prüfpfad: Wie Sie nachweisen können, was Ihr KI-Agent gesehen hat
Nachzuweisen, was ein KI-Agent gesehen hat, bedeutet, für jede einzelne Antwort rekonstruieren zu können, welche Quellen abgerufen wurden, unter welcher Identität dies geschah, welche Daten an das Modell übergeben wurden und welche Ergebnisse zurückgegeben wurden. Diese Aufzeichnung muss vom System zum Zeitpunkt der Antwort erstellt werden und lange genug erhalten bleiben, um Monate später von einer Person überprüft werden zu können, die zum Zeitpunkt der Antwort nicht anwesend war. Die meisten Implementierungen können nichts davon liefern, da sie lediglich die Konversation protokollieren, nicht jedoch die zugrunde liegenden Daten.
Dies ist die erste Frage, die in den Bereichen Finanzdienstleistungen, Gesundheitswesen und öffentlicher Verwaltung gestellt wird, und jene, die am häufigsten dazu führt, dass ein Pilotprojekt nicht in die Produktionsphase übergeht. Das Pilotprojekt liefert gute Antworten. Dann fragt jemand aus dem Risikomanagement oder der internen Revision, wie eine Antwort verteidigt werden könnte, wenn sie angefochten würde, und die ehrliche Antwort lautet: gar nicht.
Was eine Aufsichtsbehörde oder ein Prüfer tatsächlich fragt
Prüfer fragen nicht nach der Architektur. Sie fragen nach einem bestimmten Vorfall – in der Regel einem, der bereits schiefgelaufen ist – und sie stellen ihre Fragen in einer festgelegten Reihenfolge.
- Wer hat diese Anfrage gestellt? Eine namentlich genannte Person, kein Sitzungstoken oder Dienstkonto, sowie der Agent, der in deren Auftrag gehandelt hat.
- Wozu waren diese Personen zu diesem Zeitpunkt berechtigt? Nicht die heutigen Berechtigungen, sondern diejenigen, die am Tag der Antwort galten.
- Was hat das System ihr tatsächlich angezeigt? Alles, worauf sich die Antwort stützte, einschließlich des abgerufenen, aber nicht zitierten Materials.
- Woher stammte jede einzelne Behauptung? Behauptung für Behauptung, nicht als Literaturverzeichnis am Ende.
- Hat sich seitdem etwas geändert? In den Dokumenten, den Berechtigungen, dem Index und dem Modell.
- Wer hat noch dieselbe Antwort erhalten? Der Umfang der Auswirkungen – also wie aus einer einzigen falschen Antwort ein meldepflichtiges Ereignis wird.
Nur eines davon bezieht sich auf den generierten Text, weshalb ein Chat-Protokoll fast keines dieser Kriterien erfüllt.
Die Antwort, die einer Prüfung nicht standhält, lautet: „Das Modell hat es so ergeben.“ Dies beschreibt den Mechanismus, nicht den Nachweis – genauso wie die Aussage „Die Tabellenkalkulation hat es berechnet“ einen Feststellungsfall ohne die Eingabedaten und die Formel nicht abschließen würde. Aufsichtsregelwerke im Finanzdienstleistungssektor erwarten Nachweise dafür, dass die Kommunikation wirksam überprüft wurde; Datenschutzvorschriften im Gesundheitswesen verlangen Prüfkontrollen hinsichtlich des Zugriffs auf geschützte Informationen; und Programme des öffentlichen Sektors übernehmen Prüf- und Rechenschaftspflichten aus ihren Genehmigungsrahmen. Diese Verpflichtungen obliegen der Organisation, die das System einsetzt; machen Sie sie daher zu Kriterien für die Anbieterauswahl: Was protokolliert die Plattform standardmäßig, in welchem Format und wie lange? Lucidworks veröffentlicht seine eigenen Sicherheits- und Compliance-Situation, und Käufer sollten diese Konkretheit von jedem Anbieter erwarten, den sie prüfen.
Die sieben Elemente, die ein Antwortprotokoll enthalten muss
Ein Antwortprotokoll ist kein Wortprotokoll. Es handelt sich um eine strukturierte Aufzeichnung, die zum Zeitpunkt der Antwort erstellt wird – ein Eintrag pro Antwort –, und die sieben Elemente enthält.
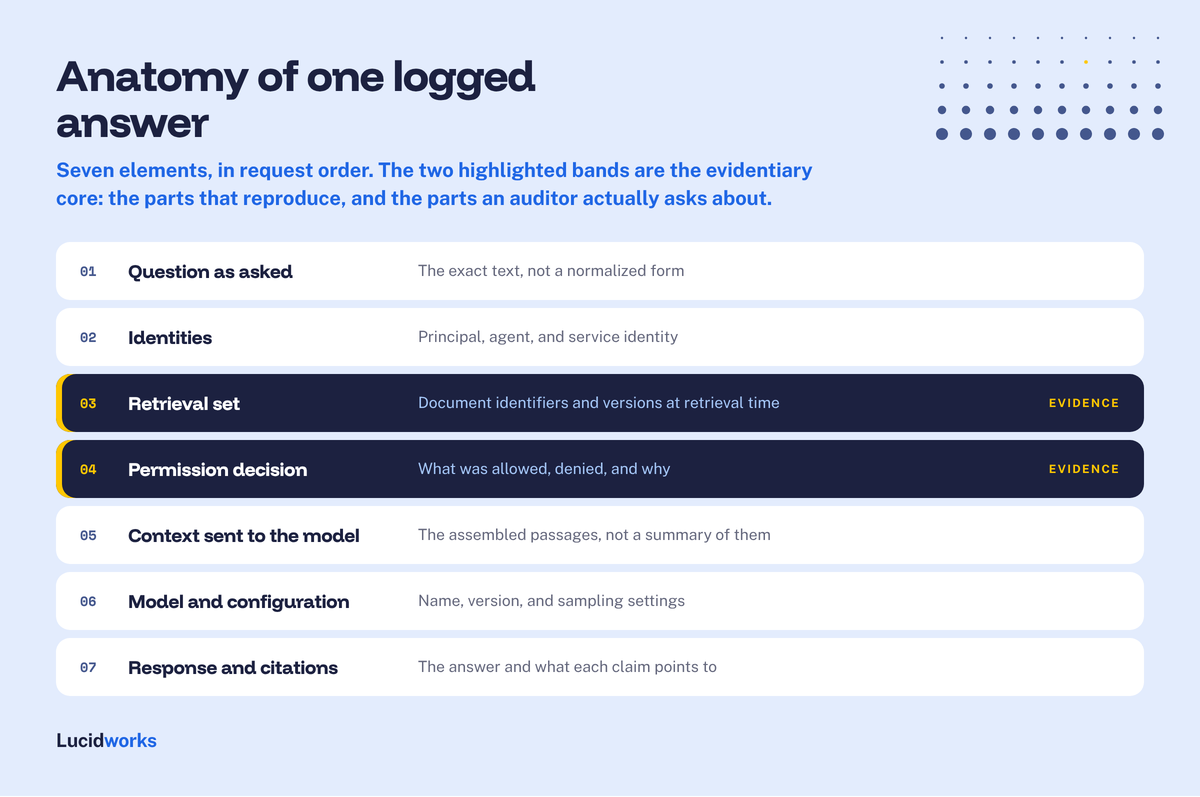
| What to record | Why it matters | What goes wrong without it |
|---|---|---|
| The question as asked | Establishes intent and exact wording, including any rewrite applied before retrieval. | You defend an answer to a question nobody asked, and cannot tell whether a rewrite changed the meaning. |
| The identity of the asker and of the agent | Separates whose authority the request ran under from which configured software acted. | Everything resolves to a shared service account, so no answer is attributable and exposure cannot be scoped. |
| The retrieval set, with document identifiers and versions | This is the evidence: what the agent saw, cited or not, as it existed at that instant. | Reconstruction fails once content is edited, and you cannot show a restricted document was never returned. |
| The permission decision applied | Records the entitlements in force at query time and what they excluded, not only what they allowed. | You cannot prove a person saw only what they were cleared for, the question every access review turns on. |
| The exact context passed to the model | Captures the assembled payload: passages, system instructions, tool outputs, and history. | You see what was retrieved and what came back, but not what the model worked from, so odd claims stay unexplained. |
| The model and configuration used | Pins the provider, model version, sampling settings, and prompt template version. | Behavior changes under you, and a silent model update gets attributed to a prompt change. |
| The response with its citations | Links each claim to the passage supporting it, rather than listing sources at the end. | Review becomes a reading exercise, and unsupported statements sitting beside good citations go unnoticed. |
Zwei Aspekte werden weitaus häufiger übersehen als die übrigen. Der erste betrifft die getroffene Berechtigungsentscheidung. Die Teams protokollieren, welche Dokumente zurückgegeben wurden, und betrachten den Zugriff als geregelt; diese Aufstellung gibt jedoch keinen Aufschluss darüber, was zurückgehalten wurde oder warum. Eine Zugriffsprüfung stellt die umgekehrte Frage, ob der betreffenden Person etwas zugestellt worden sein könnte, auf das sie keinen Anspruch hatte, und nur die Entscheidung liefert die Antwort darauf: die für diesen Prinzipal aufgelösten Gruppen und Rollen, die ausgewertete Richtlinie und die herausgefilterten Kandidaten.
Der zweite Faktor ist der genaue Kontext, der an das Modell übergeben wird. Die Diskrepanz zwischen dem, was die Suche zurückgegeben hat, und dem, was das Modell erhalten hat, ist der Grund für die meisten überraschenden Verhaltensweisen. Textpassagen werden gekürzt, um in ein Fenster zu passen, neu gewichtet, dedupliziert und mit dem Verlauf, Systemanweisungen sowie Tool-Ausgaben zusammengeführt, die niemand protokolliert hat, da sie als Anwendungscode gelten. Wenn eine Antwort eine Behauptung enthält, die in keinem der abgerufenen Dokumente zu finden ist, liegt die Erklärung in der Regel in dieser Nutzlast.
Warum die Ausgabe des Modells das Unnützlichste ist, was man protokollieren kann
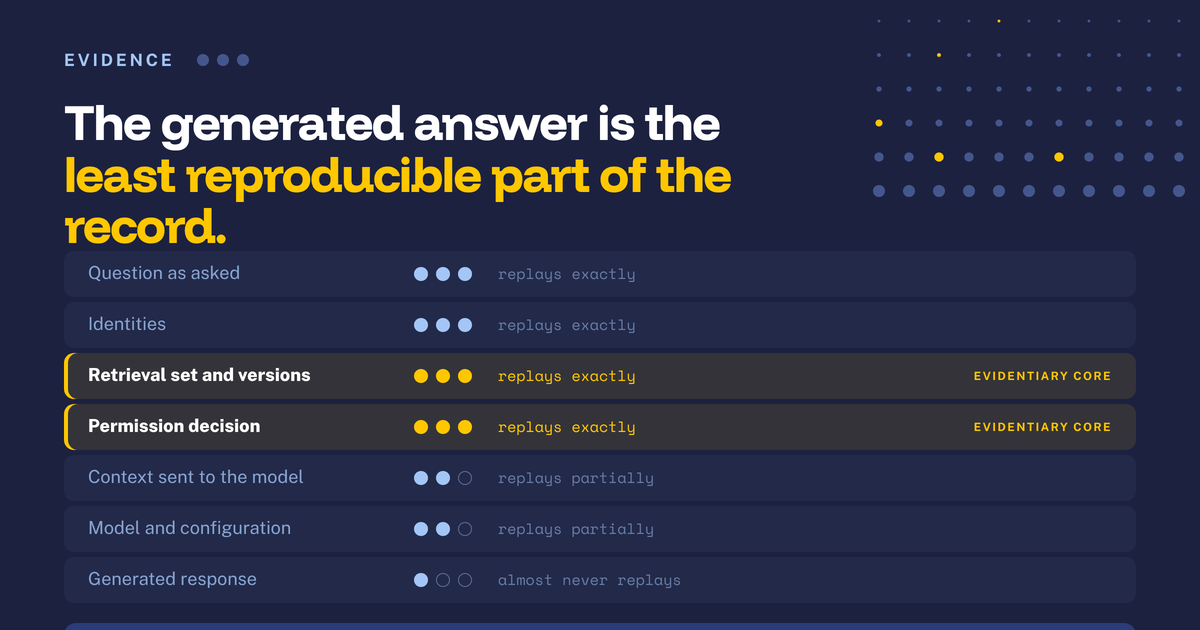
Nahezu jedes Team beginnt damit, Eingabeaufforderungen und Antworten zu protokollieren, da diese Ebene dem Nutzer am nächsten liegt und am einfachsten zu überwachen ist. Es ist zugleich die Ebene mit dem geringsten Beweiswert, da der generierte Text das am wenigsten reproduzierbare Element in der Pipeline ist. Modelle werden aktualisiert – manchmal unbemerkt –, und die Stichprobenentnahme ist standardmäßig nicht deterministisch, sodass dieselbe Eingabe bei aufeinanderfolgenden Durchläufen unterschiedliche Wörter erzeugen kann. Selbst wenn Sie an eine Version gebunden sind und die Einstellungen so deterministisch festlegen, wie es der Anbieter zulässt, verlassen Sie sich eher auf dessen Garantie als auf etwas, das Sie selbst kontrollieren.
Reproduzierbar ist alles, was vor dem Modell liegt. Die Abrufmenge ist eine Liste von Identifikatoren und Versionen und kann exakt erneut abgerufen werden. Die Berechtigungsentscheidung ist eine Funktion aus einem Prinzipal, einer Richtlinie und einer Reihe von Gruppenmitgliedschaften und kann nachgestellt werden. Der zusammengestellte Kontext ist ein Byte-für-Byte-Artefakt, das Sie festgehalten haben. Diese drei Elemente sind deterministische Aufzeichnungen dessen, was das System getan hat, und genau darauf beziehen sich die Fragen des Prüfers.
Das bloße Protokollieren der Ausgabe hinterlässt eine Mitschrift von etwas, das Sie nicht verteidigen können. Sie können zwar zeigen, was gesagt wurde, jedoch nicht, dass dies auf genehmigten Inhalten beruhte, dass der Inhalt für die fragende Person einsehbar war oder dass dieselbe Frage morgen auf dieselbe Weise behandelt würde. Unsere Untersuchungen zur Unternehmenssuche zeigen immer wieder dieselbe Tendenz: Das Vertrauen in KI-Antworten hängt von der Qualität der zugrunde liegenden Informationen ab, nicht von der Sprachgewandtheit des Textes.
Die Wiedergabe einer Antwort sechs Monate später
Sechs Monate sind ein realistischer Zeitraum. Es geht eine Beschwerde, eine Prüfung oder ein Streitfall ein, und jemand muss feststellen, was das System einer namentlich genannten Person an einem bestimmten Datum mitgeteilt hat. Bis dahin werden sich vier Faktoren verschoben haben, von denen jeder die Rekonstruktion auf unterschiedliche Weise beeinträchtigt.
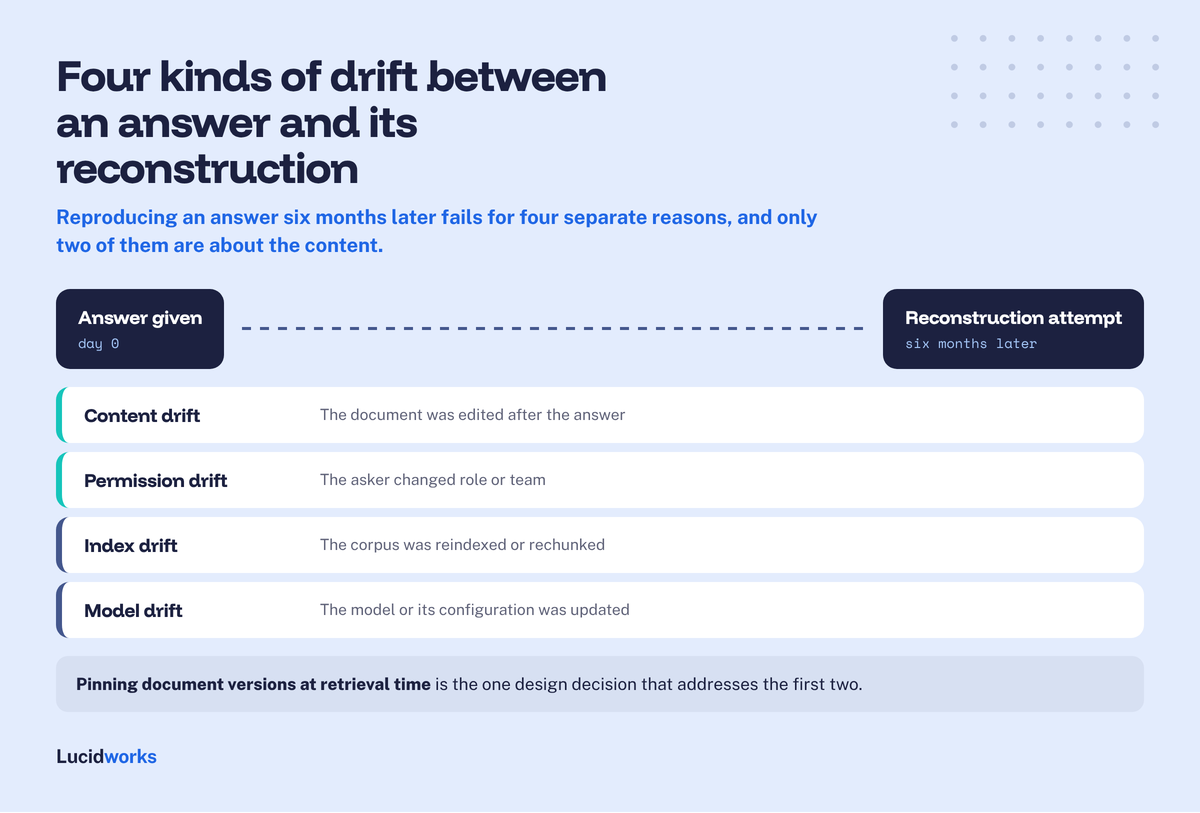
Inhaltsabweichung. Die Dokumente wurden bearbeitet: Eine Richtlinie wurde überarbeitet, ein Vertrag geändert, eine Wiki-Seite von jemandem, der aufräumte, neu verfasst. Wenn man heute dieselben Identifikatoren abruft, erhält man einen anderen Text, sodass die Rekonstruktion eine Antwort liefert, die sich nicht aus den Quellen ableiten lässt, und es so aussieht, als hätte das System etwas erfunden.
Berechtigungsabweichung. Die Person hat eine neue Rolle übernommen, eine Gruppe verlassen oder das Unternehmen verlassen. Eine erneute Abfrage unter den aktuellen Berechtigungen liefert eine andere Ergebnismenge und führt im schlimmsten Fall zu keinem Ergebnis, was als Hinweis darauf gewertet wird, dass die ursprüngliche Antwort unmöglich war.
Indexdrift. Der Korpus wurde erneut gecrawlt, neu in Chunks unterteilt oder neu eingebettet. Die Chunk-Grenzen haben sich verschoben, sodass die Passage, die eine Behauptung stützt, nicht mehr als Einheit existiert, und ein aktualisiertes Einbettungsmodell ordnet die Ergebnisse neu, selbst wenn der Text identisch ist.
Modelldrift. Der Anbieter hat eine neue Version veröffentlicht, oder Sie haben bewusst ein Upgrade durchgeführt. Derselbe Kontext führt zu einer anderen Formulierung, einer anderen Gewichtung und manchmal zu einer anderen Schlussfolgerung.
Die Entscheidung, die den Wiederaufbau ermöglicht, lautet wie folgt: Legen Sie beim Abruf nicht nur die Dokumentkennungen, sondern auch die Dokumentversionen fest. Erfassen Sie die Versions- oder Inhalts-Hash-Werte jeder abgerufenen Passage und bewahren Sie entweder den Text der Passage im Protokoll auf oder stellen Sie sicher, dass die Version im Inhaltsspeicher weiterhin adressierbar bleibt. Dies ist der einzige Punkt, den die meisten Teams falsch machen, da das Protokollieren einer Kennung als ausreichend empfunden wird und da versionsadressierbare Inhalte Speicherplatz und Aufwand für Konnektoren erfordern, anstatt die Qualität der Demo zu beeinträchtigen. Alles andere hier lässt sich in einem Sprint umsetzen. Bei diesem Punkt handelt es sich um eine architektonische Entscheidung, und eine nachträgliche Anpassung würde bedeuten, dass frühere Antworten nicht mehr rekonstruierbar sind. Für Unternehmen wie Morgan Stanley, was verdeutlicht, dass der Zustand eines Systems zu einem bestimmten Zeitpunkt eine Betriebsbedingung und keine technische Präferenz darstellt.
Auch die „Permission Drift“ erfordert die gleiche Vorgehensweise. Der Datensatz muss die getroffene Entscheidung einschließlich der festgelegten Gruppenmitgliedschaften und der Richtlinienversion enthalten, sodass die Rekonstruktion durch einen einfachen Abruf und nicht durch eine Neubewertung erfolgt.
Aufbewahrung, Unveränderlichkeit und wer das Protokoll einsehen darf
Speicherung nur im Anhangsmodus. Einträge werden einmal geschrieben und niemals an Ort und Stelle aktualisiert. Korrekturen erfolgen durch neue Einträge, die auf das Original verweisen – so wie ein Hauptbuch eine Stornierung behandelt. Der instinktive Drang, einen fehlerhaften Eintrag zu korrigieren, zerstört genau jene Eigenschaft, die das Protokoll aufbewahrenswert macht.
Manipulationssicherheit. Sie können einen Administrator mit entsprechenden Berechtigungen nicht daran hindern, Speicherinhalte zu ändern; sorgen Sie daher dafür, dass Änderungen nachweisbar sind: Verknüpfen Sie jeden Eintrag über eine Hash-Kette mit seinem Vorgänger, verankern Sie die Digests in regelmäßigen Abständen außerhalb der Kontrolle des Systems und verwenden Sie einen Speicher, der die Aufbewahrungsfrist auf Plattformebene durchsetzt. In zahlreichen Rechtsordnungen wird erwartet, dass Aufzeichnungen so aufbewahrt werden, dass sie während ihrer Aufbewahrungsfrist weder überschrieben noch gelöscht werden können, oder dass sie stattdessen im Rahmen eines überprüfbaren Prüfpfads aufbewahrt werden. Die „Broker-Dealer Books and Records Rule“, SEC-Regel 17a-4, ist das am häufigsten angeführte Beispiel, und Unternehmen, die dieser Vorschrift unterliegen, sollten ihre KI-Antwortprotokolle anhand dieser Regel abgleichen, anstatt davon auszugehen, dass eine allgemeine Protokollierung ausreicht.
Aufgabentrennung. Das Team, das das KI-System betreibt, sollte nicht in der Lage sein, dessen Prüfprotokoll zu ändern: Das Protokoll unterliegt der Verantwortung einer anderen Gruppe, wird über eine Schnittstelle geschrieben, die ausschließlich das Hinzufügen von Einträgen zulässt, und von Personen überprüft, die kein Interesse am Ergebnis haben. Sollte das Plattformteam die Nachweise seiner eigenen Arbeit bearbeiten können, wird ein Prüfer das gesamte Protokoll als unzuverlässig einstufen.
Das Protokoll enthält die vertraulichen Informationen. Erfassen Sie die abgerufenen Daten sowie den zusammengestellten Kontext, und das Protokoll enthält nun vertrauliche Dokumente, Patienteninformationen oder Geschäftsunterlagen, die an einem Ort zusammengefasst und nach Person und Datum sortiert sind. Es bedarf einer eigenen Zugriffskontrolle, Aufbewahrungsrichtlinie und Überprüfung. Der übliche Ansatz sieht eine Aufteilung der Akte vor: Metadaten und Entscheidungen befinden sich in einer allgemein lesbaren Ebene, während abgerufene Inhalte in einer eingeschränkten Ebene gespeichert sind, auf die nur über eine namentlich benannte, protokollierte Anfrage zugegriffen werden kann.
Aufbewahrungsfristen sind keine Frage der KI. Sie ergeben sich aus den Vorschriften, denen die Organisation bereits unterliegt, und gelten für die Kategorie, der das Protokoll zugeordnet ist. Klassifizieren Sie das Protokoll, ermitteln Sie die geltende Vorschrift und wenden Sie diese an.
Was ist zu protokollieren, wenn der Sachbearbeiter handelt, anstatt zu antworten?
Alle obigen Ausführungen gehen davon aus, dass der Mitarbeiter den Eintrag liest und beantwortet. In dem Moment, in dem er etwas schreibt, versendet, ablegt oder genehmigt, besteht der Schaden nicht mehr in der Offenlegung, sondern in einer Handlung, die jemand erklären oder rückgängig machen muss, und zu den sieben Elementen kommen vier weitere hinzu.
- Absicht. Die vorgeschlagene Maßnahme in strukturierter Form, bevor sie durchgeführt wurde: Vorgang, Ziel und Parameter.
- Die Richtlinienprüfung. Welche Regel hat die Aktion autorisiert, wie wurde diese anhand der Berechtigungen des Auftraggebers und der zulässigen Vorgänge des Beauftragten bewertet, und zu welchem Ergebnis führte diese Bewertung?
- Die Genehmigung, falls vorhanden. Wer hat genehmigt, wann, was wurde der Person in diesem Moment angezeigt, und ob es sich um eine explizite Genehmigung oder um eine abgelaufene Zeitüberschreitung handelte.
- Das Ergebnis. Was das Zielsystem zurückgegeben hat, einschließlich der Kennung des erstellten oder geänderten Objekts sowie ausreichender Statusinformationen, um eine Rückgängigmachung zu ermöglichen.
Lese- und Schreibprotokollierung sind unterschiedliche Probleme. Die Lese-Protokollierung weist ein hohes Volumen auf, ist im Einzelfall von geringer Bedeutung und dient der Rekonstruktion. Die Schreib-Protokollierung weist ein geringes Volumen auf, ist im Einzelfall von hoher Bedeutung, wird niemals stichprobenartig überprüft und dient der Rechenschaftspflicht sowie der Rückgängigmachung. Ein Lese-Protokoll, in dem ein Eintrag fehlt, stellt eine Lücke dar; ein Schreib-Protokoll, in dem ein Eintrag fehlt, ist eine Aktion, für die niemand Rechenschaft ablegen kann. Bauen Sie den Schreibpfad als Transaktion auf: Erfassen Sie die Absicht, holen Sie die Autorisierung ein, führen Sie die Aktion aus, protokollieren Sie das Ergebnis und behandeln Sie ein fehlendes Ergebnis als Vorfall. Legen Sie für jeden Aktionstyp fest, ob er rückgängig gemacht werden kann, von wem und innerhalb welches Zeitfensters. Aktionen, die nicht rückgängig gemacht werden können, wie beispielsweise eine ausgehende E-Mail oder eine eingereichte Einreichung, sollten standardmäßig einer Genehmigung bedürfen.
Die Datensätze in das System integrieren, anstatt sie nur anzuhängen
Teams versuchen dies in der Regel auf einer von zwei Ebenen, und beide scheitern eher aus strukturellen Gründen als aus Mangel an Einsatz. Der Datensatz muss von derselben Ebene geschrieben werden, die auch den Abruf durchführt und die Berechtigungen durchsetzt – dies ist das praktische Argument für eine Kontextschicht anstelle einer Reihe separat beschaffter Tools.
Die Protokollierung auf der Anwendungsebene – sei es in der Chat-Oberfläche oder im Agenten-Framework – erfasst die Frage, die Antwort und die Sitzung. Dabei bleibt die Berechtigungsentscheidung unberücksichtigt, die tiefer im Abrufprozess stattfindet, wo Gruppenzugehörigkeiten ermittelt und Kandidaten gefiltert werden. Die Anwendung sieht nur die verbleibenden Ergebnisse, niemals jedoch, was ausgeschlossen wurde oder warum – und genau das ist für eine Zugriffsprüfung erforderlich.
Die Protokollierung am Modell-Gateway, wo Eingabeaufforderungen und Vervollständigungen einen Proxy durchlaufen, erfasst den zusammengestellten Kontext und die Modellkonfiguration originalgetreu, lässt jedoch den Abrufprozess vollständig außer Acht. Wenn der Text das Gateway erreicht, handelt es sich bereits um eine „abgeflachte“ Nutzlast ohne Dokumentenkennungen, ohne Versionen und ohne jegliche Spur der in Betracht gezogenen und verworfenen Kandidaten. Sie erhalten die Eingabe für das Modell, jedoch keine Herkunftsinformationen dazu.
Der Datensatz muss aus der Ebene stammen, die das Abrufen und die Berechtigungsprüfung durchführt, da nur dort die Identität, die Kandidatenmenge, die Richtlinienentscheidung, die verbleibenden Passagen und deren Versionen gleichzeitig verfügbar sind. Diese Ebene ist die Kontextebene: die Laufzeitebene, die Quellen miteinander verbindet, Berechtigungen zusammen mit den Inhalten überträgt, Passagen zusammenstellt und einem Agenten einen fundierten Kontext übergibt. Beweismaterial ist kein Merkmal, das man ihr hinzufügt. Es ist ein Nebenprodukt der Ausführung dieser Aufgabe an einem einzigen Ort.
Dies ist der Ansatz, den Lucidworks bei seiner KI-Kontextdatenplattform verfolgt: Abruf, Durchsetzung von Berechtigungen und die Antwortdatei werden gemeinsam erstellt und nicht aus separaten Systemen zusammengesetzt, sodass jede Antwort die Identität enthält, unter der sie ausgeführt wurde, sowie die Dokumente und Versionen, auf die sie zurückgegriffen hat, die angewandten Berechtigungen und den an das Modell übergebenen Kontext. Agenten, die auf Lucidworks Studios basieren, übernehmen diesen Datensatz standardmäßig und nicht erst durch zusätzliche Implementierung.
Eine Checkliste zur Einsatzbereitschaft
- Wählen Sie eine Antwort aus der letzten Woche aus und setzen Sie diese von Anfang bis Ende zusammen. Was Sie nicht vorlegen dürfen, ist Ihre Lückenliste.
- Vergewissern Sie sich, dass jeder Eintrag eine Person und einen namentlich genannten Bearbeiter nennt, nicht jedoch ein gemeinsames Dienstkonto.
- Vergewissern Sie sich, dass der Abrufsatz vollständig erfasst ist, einschließlich der abgerufenen, aber nicht zitierten Dokumente.
- Vergewissern Sie sich, dass jede abgerufene Passage einen Versions- oder Inhalts-Hash enthält, nicht nur eine Dokumentenkennung.
- Vergewissern Sie sich, dass die Berechtigungsentscheidung erfasst ist, einschließlich der aufgelösten Gruppen und der ausgeschlossenen Elemente.
- Vergewissern Sie sich, dass der exakte zusammengestellte Kontext gespeichert ist, einschließlich Systemanweisungen und Tool-Ausgaben.
- Bitte stellen Sie sicher, dass das Modell, die Version, die Sampling-Einstellungen und die Version der Prompt-Vorlage für jede Antwort festgehalten werden.
- Stellen Sie sicher, dass das Protokoll nur im Anhang-Modus geführt wird, manipulationssicher ist und vom Team, das das System betreibt, nicht beschreibbar ist.
- Stellen Sie sicher, dass das Protokoll über eine eigene Zugriffskontrolle verfügt und dass seine Aufbewahrungsfrist auf einer bestehenden Richtlinie zur Aktenaufbewahrung basiert.
- Stellen Sie für jede Aktion, die ein Mitarbeiter ausführen kann, sicher, dass die Absicht, die Richtlinienprüfung, die Genehmigung, das Ergebnis und der Rückgängigmachungspfad aufgezeichnet werden.
Häufig gestellte Fragen
Reicht es aus, die Eingabeaufforderung und die Antwort zu protokollieren?
Nein. Die Eingabeaufforderung und die Antwort geben Auskunft darüber, was gesagt wurde, nicht jedoch darüber, auf welcher Grundlage das System gearbeitet hat oder ob die Person berechtigt war, den Inhalt einzusehen. Ohne den Abrufdatensatz, die Versionen und die Berechtigungsentscheidung können Sie nicht nachweisen, dass eine Antwort fundiert war, nicht nachweisen, dass eingeschränkte Inhalte zurückgehalten wurden, und die Antwort nicht rekonstruieren, sobald sich der Inhalt ändert. Dies ist die am einfachsten zu dokumentierende Ebene und zugleich der schwächste Beweis, den Sie vorlegen können.
Wie lange sollten wir Protokolle von KI-Antworten aufbewahren?
Die für Sie bereits geltenden Vorschriften regeln dies. Stufen Sie das Protokoll gemäß Ihrer bestehenden Richtlinie zur Aktenverwaltung als Datensatz ein, ermitteln Sie die für diese Klasse geltende Regel und befolgen Sie diese, anstatt eine KI-spezifische Aufbewahrungsfrist festzulegen. In regulierten Umgebungen wird die Aufbewahrungsfrist häufig in Jahren gemessen, und die Aufbewahrungsform ist ebenso wichtig wie die Dauer; prüfen Sie daher, ob Ihre Vorschriften die Aufbewahrung in einer Form vorschreiben, die nicht überschrieben werden kann.
Verlangsamt dies das System?
Der Schreibvorgang selbst ist kostengünstig und sollte auf einem asynchronen Pfad erfolgen, sodass die Auswirkungen auf die Antwortlatenz gering sind. Die eigentlichen Kosten entstehen durch den Entwicklungsaufwand für versionsadressierbare Inhalte und die Beibehaltung des zusammengestellten Kontexts, was sich eher im Speicher- und Konnektor-Aufwand als in der Antwortzeit niederschlägt. Planen Sie die Kosten für die Versionierung ein, nicht für die Protokollierung.
Was wäre, wenn unser Inhaltsspeicher keine Versionshistorie hätte?
Speichern Sie den abgerufenen Textabschnitt im Protokoll selbst – dies ist die übliche Ausweichlösung. Dies erhöht den Speicherbedarf und die Sensibilität des Protokolls, weshalb hierfür eine eingeschränkte Zugriffsebene erforderlich ist; es gewährleistet jedoch die Rekonstruktion, wenn das Quellsystem dazu nicht in der Lage ist. Das Beibehalten von Identifikatoren bedeutet lediglich, dass man akzeptieren muss, dass Antworten nicht mehr verteidigt werden können, sobald ein Dokument bearbeitet wurde.
Wem gehört der Prüfpfad – der Sicherheitsabteilung oder dem KI-Team?
In der Regel ist die Compliance- oder Risikomanagementabteilung für die Anforderung und die Aufbewahrungsregel zuständig, die Sicherheitsabteilung für die Integritätseigenschaften und das Plattformteam für die Erstellung des Datensatzes. Der Teil, der in niemandes Zuständigkeitsbereich fällt, ist der regelmäßige Test, bei dem eine frühere Antwort rekonstruiert wird, um zu überprüfen, ob sie noch funktioniert. Weisen Sie diese Aufgabe ausdrücklich zu und führen Sie sie nach einem festen Zeitplan durch, anstatt erst dann, wenn ein Prüfer danach fragt.
Können wir einfach unser bestehendes SIEM nutzen?
Zum Teil. Ein System zur Verwaltung von Sicherheitsinformationen und -ereignissen (SIEM) eignet sich gut für Metadaten und Integritätsmerkmale, und es ist sinnvoll, Antwortdatensätze an dieses System weiterzuleiten. Für Dokumentinhalte und den daraus gebildeten Kontext eignet es sich jedoch nur bedingt, da diese umfangreich und sensibel sind und keine Ereignisse darstellen. Üblicherweise werden Metadaten und Entscheidungen im SIEM verarbeitet, während die Inhalte in einem geschützten Speicher abgelegt werden, auf den die Einträge im SIEM verweisen.