
So erkennen Sie, ob Ihre Kontext-Ebene tatsächlich funktioniert
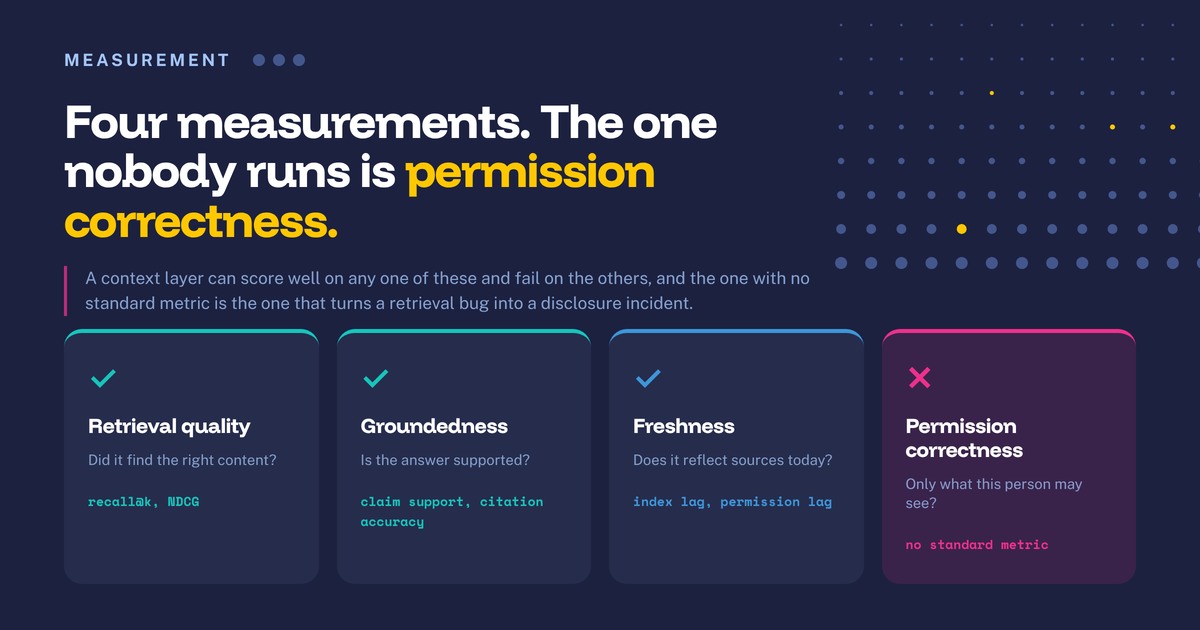
Eine Kontextschicht funktioniert, wenn sie die richtigen Inhalte abruft, ausschließlich Inhalte abruft, auf die die fragende Person Anspruch hat, Antworten liefert, die durch die abgerufenen Inhalte gestützt werden, und den aktuellen Stand der Quellsysteme widerspiegelt. Das sind vier separate Bewertungskriterien, und ein System kann jedes einzelne davon erfüllen, während es bei den anderen drei versagt. Die meisten Teams erfassen keinen dieser Punkte, da die Demo die gestellte Frage beantwortet hat und niemand festgehalten hat, was „gut beantwortet“ bedeutet hätte.
Jeder Anbieter in dieser Kategorie verkauft diese Schicht. Kaum jemand veröffentlicht Informationen darüber, wie man feststellen kann, ob das gekaufte oder selbst entwickelte Produkt auch wirklich gut ist. Im Folgenden finden Sie die Messreferenz.
Vier Fragen, vier verschiedene Bewertungskriterien
Der häufigste Fehler bei der Bewertung dieser Systeme besteht darin, alle vier Fragen zu einer einzigen Beurteilung zusammenzufassen, meist mit der Aussage „Die Antworten scheinen gut zu sein“ – was weder widerlegbar noch umsetzbar ist. Wenn eine Antwort falsch ist, muss man wissen, in welcher Phase der Fehler aufgetreten ist, da die Korrekturen in den Zuständigkeitsbereich verschiedener Teams fallen.
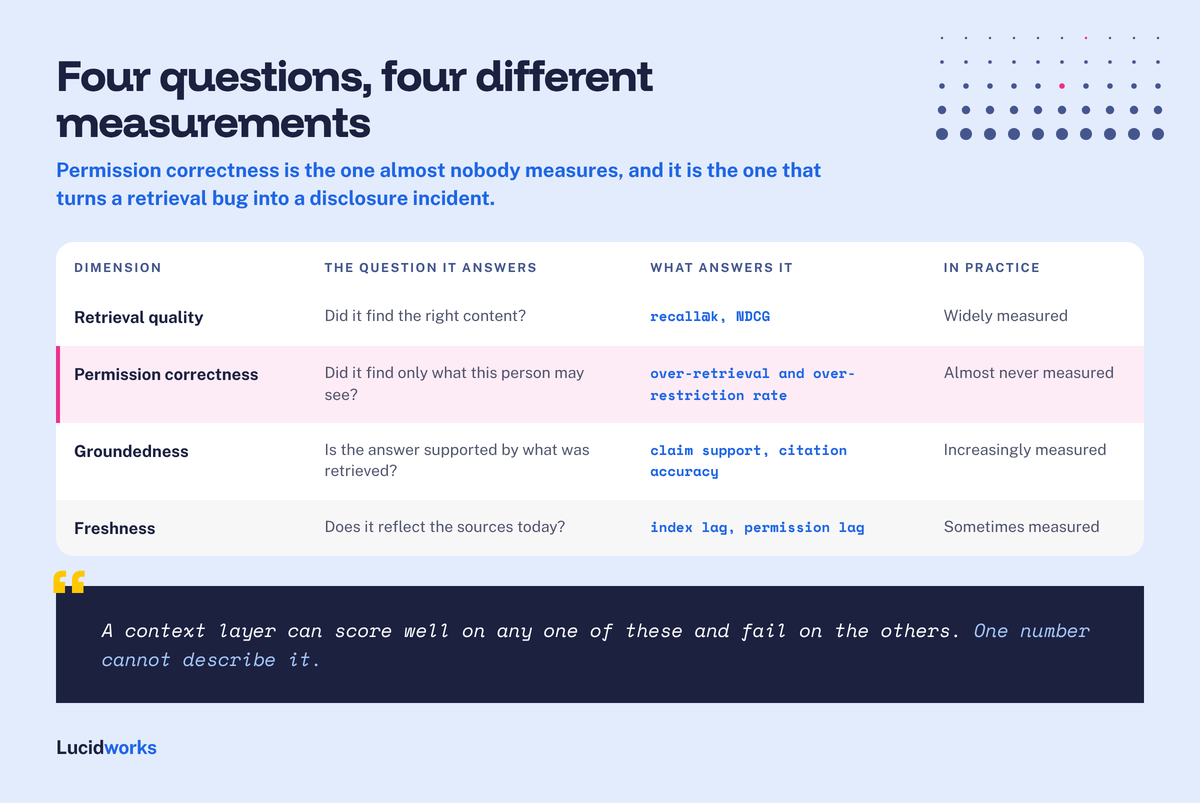
| Frage | Was Sie messen | Wie Sie es messen | Was ein schlechter Messwert bedeutet |
|---|---|---|---|
| Wurden die richtigen Inhalte gefunden? | Qualität der Suchergebnisse: Recall@k, Precision@k, NDCG, MRR | Bewertung einer beschrifteten Menge realer Suchanfragen, die nach Relevanz benotet wurden, im Vergleich zu den Ergebnissen der Suche | Der Generator hat die Antwort nie gesehen, und weder eine Anpassung der Eingabeaufforderung noch ein Modell-Upgrade kann dies beheben. |
| Hat es nur das gefunden, was diese Person sehen darf? | Richtigkeit der Berechtigungen: Überabfrage- und Überbeschränkungsraten | Vergleichen Sie die abgerufene Datenmenge mit den eigenen Zugriffsentscheidungen des Quellsystems für diesen Benutzer | Eine Überabfrage ist ein Zugriffsvorfall, der nur darauf wartet, entdeckt zu werden; eine Überbeschränkung ist eine sichere Antwort, die niemand meldet. |
| Wird die Antwort durch die gefundenen Informationen gestützt? | Fundiertheit, Relevanz der Antwort und Genauigkeit der Zitate | Prüfung der Aussagen auf der Ebene der gefundenen Textstellen: manuelle Überprüfung einer Stichprobe, automatisierte Bewertung in großem Umfang | Das System erfindet Inhalte oder zitiert echte Dokumente, die die Behauptung nicht enthalten. |
| Ist der Kontext aktuell? | Aktualität: Indexverzögerung, Berechtigungsverzögerung und Inhaltsabweichung | Vergleich der Zeitstempel zwischen Quelle und Index sowie geplante Abfragen zur Berechtigungsänderung | Die Antworten sind korrekt in Bezug auf eine Welt, die nicht mehr existiert, und die Berechtigungsverzögerung führt zu unsicheren Fehlern. |
Betrachten Sie diese Tabelle als Vertrag. Wenn ein Anbieter oder Ihr eigenes Team einen einzelnen Genauigkeitswert angibt, fragen Sie nach, auf welche Zeilen sich dieser bezieht. Die ehrliche Antwort lautet in der Regel: auf einen Teil von Zeile eins und einen Teil von Zeile drei.
Abfragequalität: Wurde der richtige Inhalt gefunden?
Vier Kennzahlen haben das größte Gewicht.
- Recall@k ist der Anteil aller für eine Suchanfrage relevanten Dokumente, die in den ersten k Ergebnissen erscheinen. Er gibt Auskunft darüber, ob das richtige Material überhaupt in das Fenster gelangt ist.
- Precision@k ist der Anteil der ersten k Ergebnisse, die relevant sind; er misst also, wie viel „Rauschen“ der Generator überspringt.
- NDCG (Normalized Discounted Cumulative Gain) bewertet die Rangfolge selbst, wobei hochrelevante Ergebnisse weiter oben belohnt und weiter unten verborgene Ergebnisse abgewertet werden; normiert, sodass eine perfekte Reihenfolge den Wert 1 erhält.
- Der MRR (Mean Reciprocal Rank) ist der Mittelwert aus „1“ geteilt durch die Position des ersten relevanten Ergebnisses und misst, wie schnell ein Leser auf nützliche Informationen stößt.
Bei einer Kontext-Ebene kommt es vor allem auf die Recall-Rate an, denn ein Modell kann zwar eine irrelevante Passage ignorieren, aber keine erfinden, die nie abgerufen wurde. Präzision und Rangfolge spielen zwar weiterhin eine Rolle, da Kontextfenster endlich sind und Rauschen Kosten sowie Latenz verursacht, doch ein Versagen bei der Recall-Rate lässt sich nachgelagert nicht mehr beheben. Das steht im Widerspruch zum Instinkt von Teams, die aus dem Bereich der klassischen Website-Suche kommen.
Verwenden Sie eine abgestufte Relevanzbewertung anstelle von binären Beurteilungen. Eine binäre Einstufung lässt den Unterschied zwischen einer Passage, die die Frage vollständig beantwortet, einer, die einen Teil der Antwort enthält, und einer, die lediglich das richtige Thema behandelt, außer Acht. Eine Vier-Punkte-Skala bewahrt diese Informationen, die für die Aussagekraft des NDCG entscheidend sind; NDCG im Vergleich zu binären Einstufungen ist eine schwächere Metrik mit einem ausgeklügelten Namen.
Wenn die Trefferquote schlecht ist, liegt die Ursache in der Regel vor dem Ranker: Passagen sind so aufgeteilt, dass die Antwort über eine Grenze hinwegreicht – weshalb das Chunking die Grundlage für eine genaue Trefferauswahl ist – oder es liegt eine Vokabular-Diskrepanz vor, die nur durch eine hybride Kombination aus Schlüsselwort- und Vektorabgleich behoben werden kann, wie dieser Leitfaden zur semantischen Suche erklärt. Zuerst messen, dann die Datenerfassung überprüfen, schließlich den Ranker optimieren. Teams gehen zuverlässig in umgekehrter Reihenfolge vor.
Korrektheit der Berechtigungen: Wurde nur das gefunden, was diese Person sehen darf?
Richtigkeit der Berechtigungen ist der Anteil der für eine Anfrage abgerufenen Dokumente, zu deren Öffnung der anfragende Benutzer tatsächlich berechtigt war, gemessen durch den Abgleich der abgerufenen Dokumente mit den Zugriffsentscheidungen der Quellsysteme für diesen Benutzer. Dieser letzte Satz fasst die gesamte Methode zusammen: Sie implementieren das Berechtigungsmodell von SharePoint in Ihrem Test nicht neu, was lediglich beweisen würde, dass zwei Ihrer Implementierungen übereinstimmen. Außerdem setzt dies voraus, dass die Anfrage überhaupt die Identität der anfragenden Person enthielt, was ein ein eigenständiges Problem und eine häufige Fehlerquelle. Sie fragen das Referenzsystem für jedes Dokument und jeden Benutzer ab, ob Zugriff gewährt würde, und vergleichen das Ergebnis mit dem, was die Abfrage zurückgegeben hat.
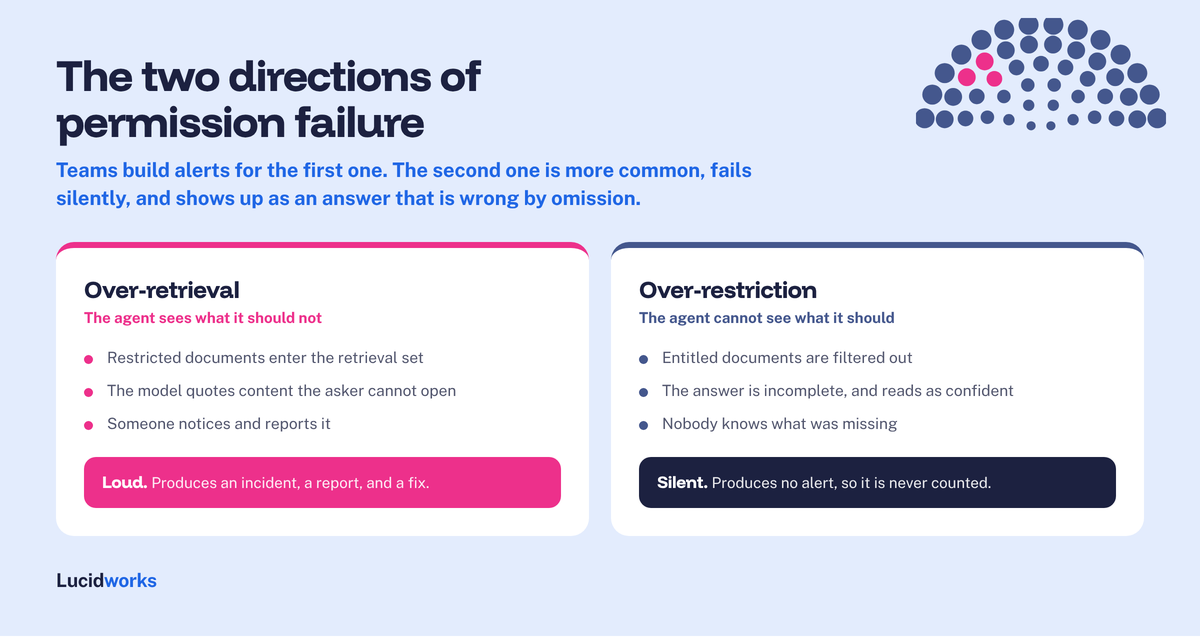
Unter „Over-Retrieval“ versteht man, dass der Akteur etwas sieht, was er nicht sehen sollte: Ein vertrauliches Dokument gelangt in den Kontextbereich, und sein Inhalt oder eine Zusammenfassung davon gelangt an jemanden, der keinen Zugriff darauf haben darf. Das ist der Fehler, den sich jeder vorstellt, und er macht sich letztendlich bemerkbar, da der Empfänger oft erkennt, dass er diesen Inhalt gar nicht haben dürfte.
Eine übermäßige Einschränkung ist das Gegenteil: Inhalte, auf die die Person voll und ganz Anspruch hat, werden vorenthalten, meist weil eine Gruppenzugehörigkeit nicht erweitert wurde, eine geerbte Berechtigung bei der Erfassung nicht erfasst wurde oder eine konservative Standardeinstellung ein Dokument ausgeschlossen hat, dessen Zugriffskontrollliste nicht aufgelöst werden konnte. Die Antwort wird selbstbewusst, flüssig und mit Quellenangaben zurückgegeben – und ist dennoch durch Auslassung falsch, da eine Antwort, die auf acht von elf relevanten Dokumenten basiert, genau so aussieht wie eine, die auf allen elf basiert.
Eine zu strenge Einschränkung ist der stillere Fehler und in den meisten Implementierungen der häufigere, da jeder mehrdeutige Fall in einer Erfassungspipeline von Haus aus in die sichere Richtung aufgelöst wird. Teams erkennen meist nur die erste Art. Geben Sie zwei Zahlen an, da eine einzelne Zahl zur Berechtigungsgenauigkeit den Kompromiss verschleiert: Man kann die Überabfrage auf null reduzieren, indem man fast gar nichts zurückgibt.
Führen Sie kontinuierlich Stichproben durch, anstatt nur einmal zu prüfen. Ein Berechtigungsmodell ist keine Eigenschaft Ihrer Software; es ist Ihre Software in Verbindung mit dem aktuellen Zustand jeder Gruppe, jeder Rolle und jeder Freigabeentscheidung in jedem verbundenen System – und dieser Zustand ändert sich täglich. Spielen Sie regelmäßig eine fortlaufende Stichprobe ab und lösen Sie bei Änderungen eine Warnung aus, denn eine einmalige Zertifizierung während der Beschaffung beschreibt eine Konfiguration, die nicht mehr existiert.
Fundiertheit: Wird die Antwort tatsächlich durch die abgerufenen Daten gestützt?
Die Fundiertheit prüft, ob jede Aussage in der Antwort durch eine aus dem Text entnommene Passage gestützt wird. Die Relevanz der Antwort prüft, ob die Antwort die Frage beantwortet. Diese beiden Aspekte müssen getrennt gemessen werden, da eine Antwort zwar perfekt fundiert, aber nutzlos sein kann – indem sie beispielsweise drei Dokumente, die nichts mit der Frage zu tun haben, originalgetreu zusammenfasst – oder aber hochrelevant und dennoch vollständig erfunden sein kann. Die Abhilfemaßnahmen unterscheiden sich: Mängel bei der Fundiertheit deuten auf den Generator hin, Mängel bei der Relevanz hingegen auf die Dokumentenauswahl.
Messen Sie die Fundiertheit pro Behauptung statt pro Antwort: Zerlegen Sie den generierten Text in einzelne Aussagen und vergleichen Sie jede davon mit der abgerufenen Menge. Was Sie benötigen, ist eine Quote sowie die Liste der nicht belegten Behauptungen – dies ist für einen Ingenieur nützlicher als eine Punktzahl. All dies setzt voraus, dass die abgerufene Menge zum Zeitpunkt der Antwort erfasst wurde; dies ist das Erste, was ein Antwortprotokoll enthalten muss.
Genauigkeit der Quellenangaben ist eine Überprüfung an sich. Ein Verweis auf ein echtes Dokument, das die Behauptung nicht enthält, ist schlimmer als gar kein Verweis, da er gesunde Skepsis in unangebrachtes Vertrauen verwandelt; niemand öffnet die vierte Quelle. Messen Sie den Anteil der Zitate, bei denen die zitierte Passage die damit verbundene spezifische Behauptung stützt, und behandeln Sie einen Rückgang als dringlich, selbst wenn die Fundiertheit stabil erscheint, da sich beide unabhängig voneinander entwickeln, wenn ein System korrekte Behauptungen der falschen Quelle zuordnet. Zu erkennen, warum ein Ergebnis an einer bestimmten Stelle rangiert, ist das Ziel hinter Suchrankings nachvollziehbar machen, bietet Ihnen eine Anlaufstelle, wenn ein Zitat nicht ganz passt.
Aktualität: Ist der Kontext aktuell?
Der Index-Verzug ist die Zeitspanne zwischen einer Änderung an der Quelle und dem Zeitpunkt, zu dem diese Änderung abrufbar ist. Messen Sie ihn pro Konnektor und geben Sie eine Verteilung statt eines Durchschnittswerts an, da ein einzelner langsamer Konnektor in einem gemittelten Wert untergeht und es gerade die Ausreißer am Ende der Verteilung sind, die zu Vorfällen führen.
Inhaltsdrift ist der Anteil der indizierten Dokumente, deren Quelle sich inzwischen geändert hat, ersetzt wurde oder gelöscht wurde. Sie erfasst Dokumente, die an der Quelle zurückgezogen wurden, aber weiterhin Fragen beantworten.
Die Berechtigungsverzögerung ist die Zeitspanne zwischen einer Zugriffsänderung an der Quelle und dem Inkrafttreten dieser Änderung beim Abruf. Sie ist besonders gefährlich, da sie stillschweigend und in die unsichere Richtung versagt. Jemand wechselt am Montagmorgen seine Rolle, seine Verzeichnisgruppen werden aktualisiert, doch der Index erfährt davon erst bei der nächsten Berechtigungssynchronisierung. Daher liefert der Agent weiterhin Ergebnisse aus Inhalten, auf die er bereits seit Stunden keinen Zugriff mehr hat. Es treten keine Fehler auf, es werden keine Protokolle erstellt, und das Ergebnis ist hervorragend. Messen Sie diesen Effekt getrennt vom Index-Verzögerung, da der Berechtigungszeitplan fast immer der langsamere der beiden ist.
Erstellen eines Bewertungsdatensatzes, den Sie tatsächlich pflegen werden
Alles oben Genannte hängt von einem Evaluierungsdatensatz ab, den Teams oft überspringen, weil er unspektakulär ist und niemand ihn übernehmen will. Erstellen Sie es anhand echter Abfrageprotokolle und wählen Sie dabei drei Bereiche aus: „Head“-Abfragen, die viele Nutzer stellen, „Torso“-Abfragen, die innerhalb eines Teams immer wieder vorkommen, und „Tail“-Abfragen, die eine Person einmal gestellt hat. Im „Tail“-Bereich versagt das System, und dorthin gelangen erfundene Benchmarks niemals, da die Verfasser von Testfragen unbewusst „Head“-Abfragen erstellen.
Einige hundert Abfragen sind aus praktischen – und nicht aus statistischen – Gründen die richtige Größenordnung. Diese Zahl ist klein genug, dass Fachexperten die Kennzeichnung abschließen und einer Aktualisierung zustimmen können, und groß genug, dass eine echte Veränderung bei der Suchergebnisausgabe das Gesamtergebnis über das Kennzeichnungsrauschen hinaushebt. Unterhalb von etwa hundert können einzelne Meinungsverschiedenheiten Ihre Metriken stark beeinflussen; oberhalb von tausend lässt die Qualität der Kennzeichnung nach.
Die Kennzeichnung ist Aufgabe derjenigen, die sich in dem Fachgebiet auskennen, und nicht des Teams, das das System entwickelt hat. Lassen Sie zwei Personen eine sich überschneidende Teilmenge kennzeichnen und untersuchen Sie dabei etwaige Meinungsverschiedenheiten, anstatt diese durch Mittelwertbildung auszugleichen: Wenn zwei Experten eine Abfrage unterschiedlich bewerten, deutet dies in der Regel auf eine mehrdeutige Frage oder einen Konflikt im Korpus hin – und beides sind wichtige Erkenntnisse.
Aktualisieren Sie den Datensatz vierteljährlich und nach einer umfangreichen Migration oder Umstrukturierung noch früher. Seien Sie ehrlich: Der Datensatz verliert an Aussagekraft, wenn sich der Datenbestand, das Geschäft und die Fragestellungen ändern. Ein nicht gepflegter Bewertungsdatensatz ist schlimmer als gar keiner, da er stabile, beruhigende Zahlen liefert, die keiner Realität entsprechen und mit ungerechtfertigtem Selbstvertrauen an die Führungsebene weitergeleitet werden.
Wo LLM als „Richter“ hilft und wo es danebenliegt
Die Verwendung eines Modells zur Bewertung der Ergebnisse macht den Umfang erschwinglich, und es gibt dokumentierte Fehlerquellen. Positionsverzerrung: Bewerter bevorzugen den Kandidaten, der zuerst angezeigt wird; bewerten Sie daher in beiden Reihenfolgen und bilden Sie den Durchschnitt. Ausführlichkeitsverzerrung: Längere, flüssigere Antworten erhalten unabhängig von ihrer Richtigkeit höhere Punktzahlen, was für fundierte Unternehmensantworten kontraproduktiv ist. Selbstpräferenz: Ein Bewerter bevorzugt die Ergebnisse aus seiner eigenen Modellfamilie; wenn also Bewerter und Generator dieselbe Modellfamilie nutzen, wird teilweise die stilistische Affinität gemessen. Prompt-Sensitivität: Die Bewertungen ändern sich bereits bei kleinen Umformulierungen; daher sollte die Prompt-Formulierung des Bewerters in verschiedenen Versionen verwendet und jede Änderung daran als Änderung des Bewertungsinstruments behandelt werden.
Führen Sie in jedem Zyklus eine Kalibrierung anhand menschlicher Bewertungen für eine Teilmenge durch und geben Sie die Übereinstimmungsrate neben den bewerteten Werten an. Eine Übereinstimmung bei vier von fünf Fällen macht die bewertete Zahl zu einem brauchbaren Indikator für die Bewegung; drei von fünf bedeuten, dass Sie lediglich den Geschmack des Bewerters wiedergeben.
Es eignet sich wirklich gut für die Überprüfung der Fundiertheit und der Quellenangaben bei großen Datenmengen, denn die Frage, ob diese Behauptung durch diese Passage gestützt wird, ist eine eng gefasste, lokale und überprüfbare Beurteilung, die Modelle gut und kostengünstig vornehmen können. Bei der fein abgestuften Relevanzbewertung ist es jedoch unzuverlässig: Hier hängt die Unterscheidung zwischen einer Passage, die eine Frage vollständig beantwortet, und einer, die sie nur teilweise beantwortet, davon ab, was der Fragesteller bereits weiß, was die Organisation unter bestimmten Begriffen versteht und welches von zwei widersprüchlichen Dokumenten maßgeblich ist. Das ist Fachurteilsvermögen. Überlassen Sie die Relevanzbeurteilung den Menschen und nutzen Sie Modelle zur Überprüfung der Belegung.
Wie die Zahlen in der Praxis aussehen
Dieser Artikel wird Ihnen keine Zielwerte nennen, denn eine Zahl, die ohne Angabe des Korpus und des Bewertungssatzes genannt wird, aus denen sie stammt, ist reine Augenwischerei. Ein NDCG-Wert von 0,82 bei einem sauberen öffentlichen Benchmark und ein NDCG-Wert von 0,82 bei einem umfangreichen Korpus aus sich überschneidenden politischen Dokumenten sind nicht miteinander vergleichbar, wobei Letzteres weitaus schwieriger ist. Es gibt keinen allgemein gültigen „guten“ Wert.
Schauen Sie sich stattdessen Ihre eigenen Zahlen an. Legen Sie eine Ausgangsbasis fest, bevor Sie etwas ändern, denn ohne diese ist jede spätere Verbesserung nur eine Anekdote. Messen Sie die Abweichungen anhand desselben Datensatzes, wobei die Kennzeichnungsmethode konstant bleibt. Legen Sie intern Schwellenwerte fest, wie beispielsweise eine maximale Überabrufrate oder eine Obergrenze für die Verzögerung bei der Erteilung von Berechtigungen, die sich aus Ihrer regulatorischen Position ableiten und nicht aus dem Benchmark eines anderen.
Behandeln Sie jeden von einem Anbieter angegebenen absoluten Schwellenwert mit Vorsicht – auch unseren. Fragen Sie nach, auf welcher Datenbasis er ermittelt wurde, wie die Relevanz bewertet wurde und von wem, und ob dieselbe Methode bei Ihren Inhalten zu einem vergleichbaren Ergebnis führen würde.
Lucidworks vertritt den Standpunkt, dass die Messung innerhalb der Plattform und nicht neben ihr stattfinden sollte: Berechtigungen werden zum Zeitpunkt der Abfrage geklärt, sodass die Korrektheit nachverfolgt werden kann; die Aufteilung in Blöcke und das Ranking sind überprüfbar, sodass sich die Ursache eines Abruffehlers zurückverfolgen lässt; und die Lucidworks-KI legt die hinter jeder Antwort stehende Ergebnismenge offen, sodass die Fundiertheit anhand der tatsächlich abgerufenen Daten überprüft werden kann. Das ist die Designabsicht hinter der „AI Context Data Platform“, wie Lucidworks seinen Ansatz in dieser Kategorie nennt. Unterziehen Sie sie denselben vier Fragen wie jeden anderen Ansatz auch.
Ein 30-tägiger Testplan
| Woche | Was Sie tun | Was Sie am Ende haben |
|---|---|---|
| Woche 1 | Entnehmen Sie Beispielprotokolle aus realen Abfragen aus den Bereichen „Head“, „Torso“ und „Tail“. Legen Sie die Bewertungsskala fest und rekrutieren Sie zwei oder drei Fachgutachter. Pro Abfrage sollten Sie nicht nur die Antwort, sondern auch die abgerufene Datenmenge protokollieren. | Ein Abfragebeispiel, eine Bewertungsskala, namentlich genannte Bewerter und die Protokollierung – alles andere hängt davon ab. |
| Woche 2 | Kennzeichnen Sie die Datenmenge mit einer überlappenden Teilmenge zur Übereinstimmung und klären Sie Unstimmigkeiten. Berechnen Sie Recall@k, Precision@k, NDCG und MRR. | Eine beschriftete Datenmenge und eine Referenzmethode für die Dokumentensuche, die Sie begründen können. |
| Woche 3 | Erstellen Sie den Replay-Harness: Fragen Sie anhand einer Stichprobe von Anfragen bei jedem Quellsystem nach, ob der anfragende Benutzer jedes abgerufene Dokument öffnen darf. Berechnen Sie „Over-Retrieval“ und „Over-Restriction“ getrennt voneinander und messen Sie beide Verzögerungsarten pro Konnektor. | Zwei Berechtigungswerte, zwei Verzögerungswerte – und Ihre erste echte Überraschung. |
| Woche 4 | Führen Sie Überprüfungen der Fundiertheit und der Zitierpraxis durch – automatisiert in großem Umfang und manuell anhand einer Stichprobe –, wobei der Bewerter anhand dieser Kennzeichnungen kalibriert wird. Erstellen Sie eine Bewertungsübersicht. | Eine Basislinie für alle vier Dimensionen, einen Schwellenwert für jede einzelne sowie einen namentlich benannten Verantwortlichen. |
| Laufend | Führen Sie den Datensatz bei jeder wesentlichen Änderung hinsichtlich der Erfassung, des Abrufs oder der Aufforderung erneut durch. Überprüfen Sie kontinuierlich die Richtigkeit der Berechtigungen und aktualisieren Sie den Datensatz vierteljährlich. | Daten statt Anekdoten – und eine Zahl, die man vorweisen kann, wenn jemand fragt, ob es funktioniert. |
Häufig gestellte Fragen
Was ist ein guter NDCG-Wert?
Es gibt keinen allgemeingültigen Schwellenwert, und wer einen solchen angibt, berücksichtigt nicht Ihr Korpus. Der NDCG-Wert hängt davon ab, wie die Relevanz bewertet wurde, wie viele relevante Dokumente pro Suchanfrage vorhanden sind, wie groß der Wert von k ist und wie viele fast identische Inhalte sich im Index befinden. Daher fällt die Bewertung eines Systems bei zwei verschiedenen Korpora sehr unterschiedlich aus. Der Wert ist nur als Differenz zu Ihrer eigenen Basislinie aussagekräftig.
Wie messen wir die Richtigkeit von Berechtigungen, ohne einen Sicherheitsvorfall zu verursachen?
Wiedergeben statt prüfen. Erfassen Sie die Dokumente, die bei einer echten Anfrage abgerufen wurden, fragen Sie dann in einem Test-Harness jedes Quellsystem ab, ob diesem Benutzer Zugriff auf jedes einzelne Dokument gewährt würde, und vergleichen Sie die beiden Sätze. Es werden keine zusätzlichen Informationen preisgegeben, da die Testumgebung bereits getroffene Entscheidungen überprüft und einen booleschen Wert anstelle von Inhalten zurückgibt. Führen Sie den Test an einer fortlaufenden Stichprobe durch und protokollieren Sie beide Fehlerrichtungen.
Können wir die Nutzer nicht einfach fragen, ob die Antworten in Ordnung sind?
Nutzer-Feedback ist ein nützlicher Anhaltspunkt, reicht aber allein nicht aus. Nutzer können Ihnen mitteilen, dass eine Antwort nicht hilfreich oder offensichtlich falsch war – diese Rückmeldungen sind es wert, erfasst zu werden. Sie können Ihnen jedoch nicht mitteilen, dass drei Dokumente fehlten, auf die sie Anspruch hatten, die sie aber nie gesehen haben, dass ein Verweis auf ein Dokument verweist, das den Anspruch nicht enthält, oder dass der Inhalt bereits sechs Wochen alt war, da alle drei Fälle aus ihrer Sicht identisch mit einer korrekten Antwort aussehen.
Wie viele Suchanfragen benötigt ein Bewertungssatz?
Einige Hundert Beispiele, verteilt auf Kopf, Rumpf und Schwanz, reichen für die meisten Unternehmensanwendungen aus. Bei weniger als etwa hundert Beispielen können bereits wenige Abweichungen bei der Beschriftung das Gesamtergebnis beeinflussen; bei mehr als tausend Beispielen verschlechtert sich die Qualität der Beschriftung, und der Datensatz wird nicht mehr aktualisiert. Die entscheidende Einschränkung besteht darin, ob Fachexperten die Daten in drei Monaten erneut beschriften werden.
Wie oft sollten wir die Auswertung wiederholen?
Führen Sie den vollständigen Test bei jeder wesentlichen Änderung an der Datenaufnahme, der Chunking-Verarbeitung, dem Abruf oder der Prompt-Generierung durch und betrachten Sie ihn eher als Freigabekriterium denn als Bericht. Überprüfen Sie die Korrektheit und Aktualität der Berechtigungen kontinuierlich, da diese von den verbundenen Systemen und nicht von Ihrem Code abhängen und sich an einem Tag, an dem Sie keine Änderungen veröffentlicht haben, verschlechtern können. Aktualisieren Sie den Satz vierteljährlich sowie nach jeder Umstrukturierung, die die Gruppenstruktur verändert.
Wer sollte dafür verantwortlich sein – das Suchteam oder das Sicherheitsteam?
Teilen Sie es nach Dimensionen auf und benennen Sie für jede Dimension eine verantwortliche Person. Die Qualität der Datenermittlung und die Fundiertheit liegen in der Verantwortung des Plattformteams, das auf das Ergebnis reagieren kann. Die Richtigkeit der Berechtigungen liegt gemeinsam in der Verantwortung der Bereiche Sicherheit und Identitätsmanagement, da die Korrektur in der Regel eher in der Gruppenzuordnung oder der Konfiguration der Konnektoren als in der Datenermittlung selbst erfolgt, und die Aktualität liegt in der Verantwortung derjenigen, die für die Konnektoren zuständig sind.
Liefert uns ein Anbieter-Benchmark nützliche Erkenntnisse?
Es gibt Aufschluss darüber, was der Anbieter gemessen hat, was auf seine Weise informativ ist. Fragen Sie, aus welchem Korpus die Zahl stammt, wie die Relevanz bewertet wurde und von wem, und ob dieselbe Methode bei Ihren Inhalten zu einem vergleichbaren Ergebnis führen würde. Ein Anbieter, der alle drei Fragen beantwortet und anbietet, die Methode auf Ihre Daten anzuwenden, ist hilfreich; ein einzelner Genauigkeitsprozentsatz ohne Angabe der zugrunde liegenden Methode ist reines Marketing.