
Was ist eine Kontext-Ebene für unstrukturierte Unternehmensinhalte?
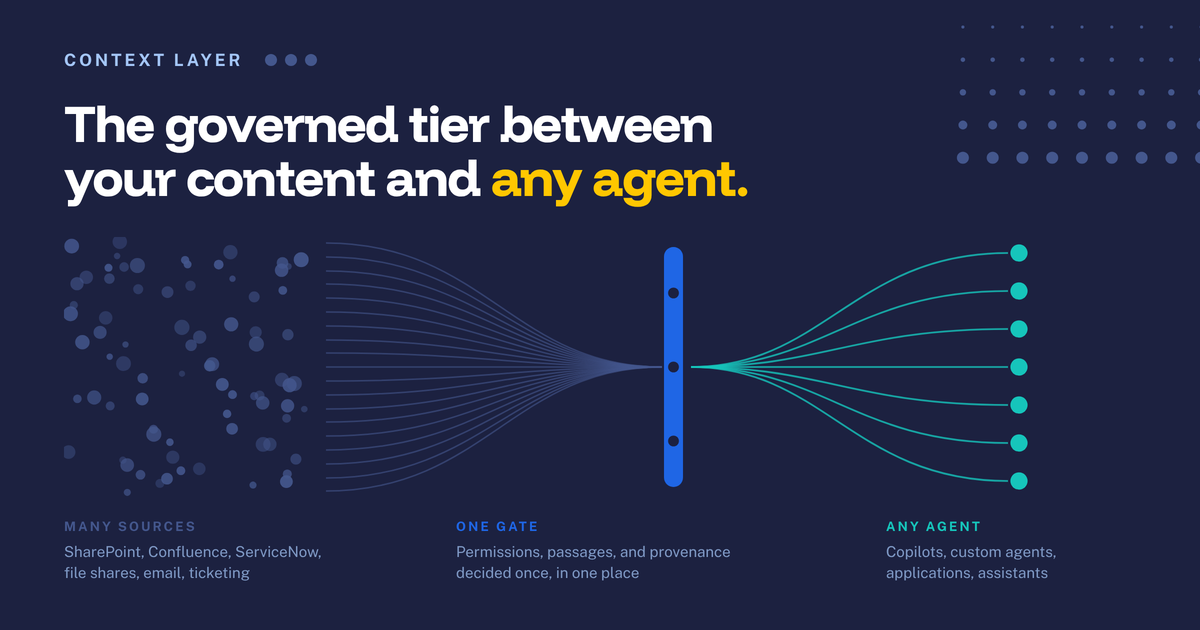
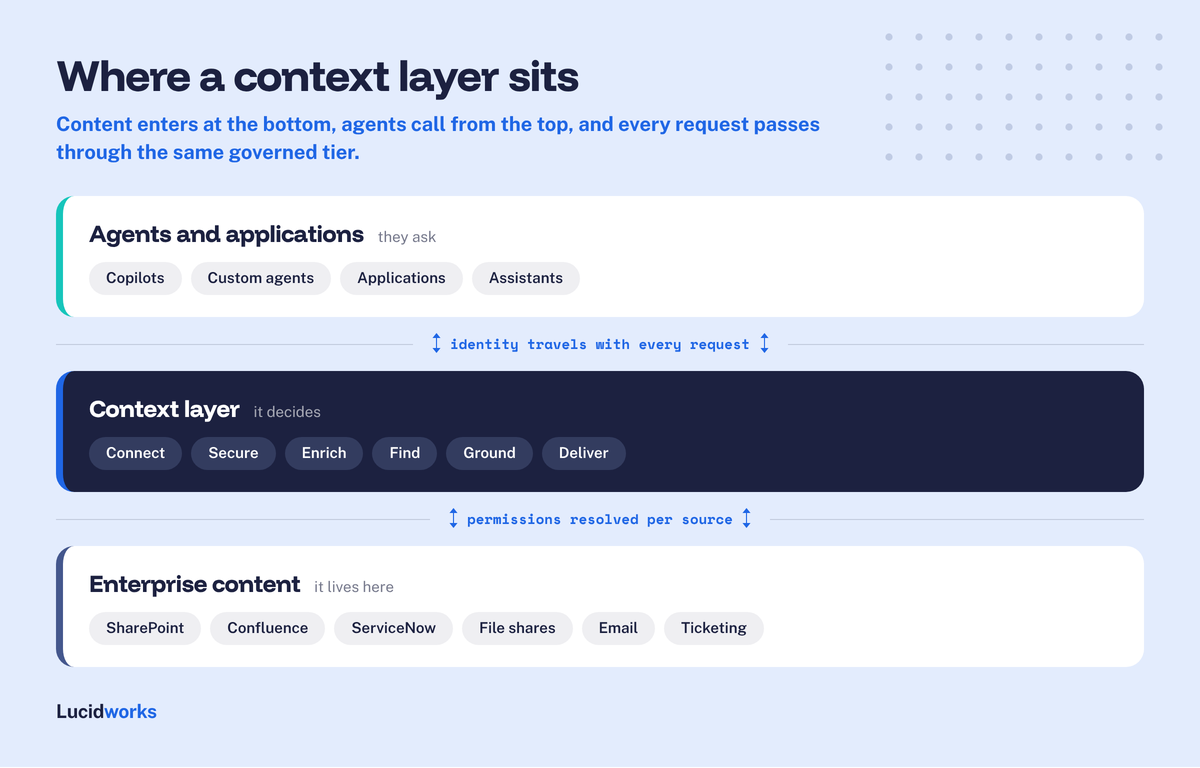
Eine Kontext-Ebene ist die geregelte Schicht zwischen den unternehmenseigenen Informationen und den KI-Agenten, die diese abfragen. Sie ist für drei Dinge zuständig: die Zusammenstellung der richtigen Inhalte für eine bestimmte Anfrage, die Durchsetzung der Zugriffsberechtigungen zum Zeitpunkt der Anfrage sowie die Rückgabe dieser Inhalte in einer Form, die ein Modell tatsächlich nutzen kann. Anders ausgedrückt: Hier werden Abruf, Durchsetzung von Zugriffsberechtigungen und Herkunftsnachweis zu einem festen Bestandteil der Architektur, anstatt innerhalb jeder einzelnen Anwendung improvisiert zu werden.
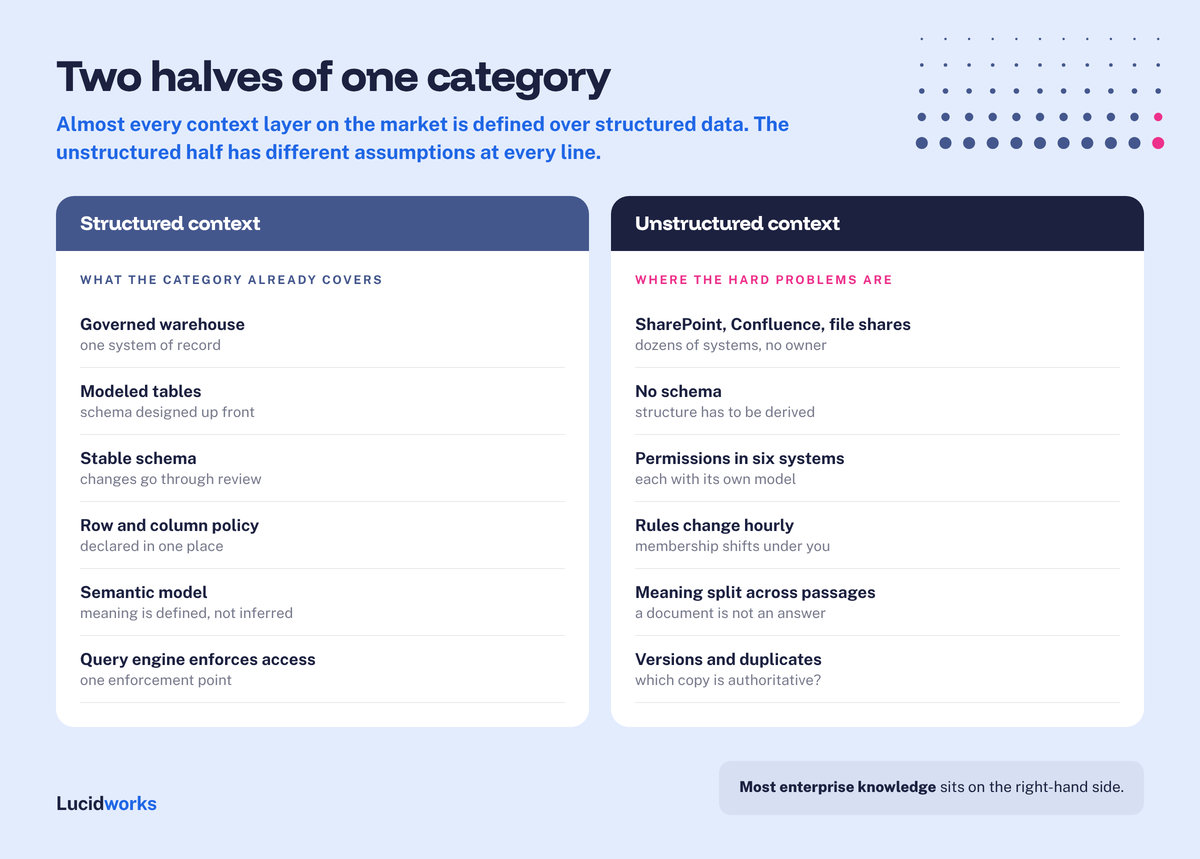
Nahezu jede bisher veröffentlichte Definition beschreibt diese Ebene als strukturierte Daten: Kennzahlen, Tabellen, Verknüpfungen und semantische Modelle auf der Grundlage eines Data Warehouse. Das ist die eigentliche Hälfte des Problems – und die einfachere Hälfte. Die schwierigere Hälfte sind unstrukturierte Inhalte: die Dokumente, Tickets, Wikis, Verträge, PDF-Dateien, Richtlinienhandbücher und E-Mail-Verläufe, in denen der Großteil des Unternehmenswissens gespeichert ist und in denen nahezu jedes Problem der Zugriffskontrolle seinen Ursprung hat. Dieser Artikel definiert die Kategorie, wie sie Ende 2026 aussieht, und legt dar, was zu tun ist, wenn Inhalte kein Schema aufweisen.
Warum es diese Kategorie nun gibt
„Kontext-Ebene“ war ab 2026 nicht mehr nur ein in Blogbeiträgen geprägter Begriff, sondern wurde zu einer eigenständigen Analystenkategorie. Im August 2026 veröffentlichte Gartner einen Marktüberblick zu KI-Kontextplattformen, in dem KI-Kontextplattformen als Software definiert wurden, die wiederverwendbaren Kontext aufbaut, verwaltet und diesen KI-Agenten zur Laufzeit bereitstellt. Die drei Verben sind entscheidend: „Erstellen“ bedeutet Abruf und Zusammenstellung, „Verwalten“ steht für Zugriff und Richtlinien, und „Bereitstellen zur Laufzeit“ räumt ein, dass es sich hierbei um ein Problem der Online-Bereitstellung handelt und nicht um eine Batch-Modellierung.
Forrester definiert diese Ebene anhand ihrer Entwicklungsgeschichte und beschreibt die Kontext-Ebene als die nächste Entwicklungsstufe semantischer Ebenen und Wissensgraphen; ein entsprechender „Landscape“-Bericht soll Ende des vierten Quartals 2026 erscheinen; diese Darstellung können Sie im Blogbeitrag von Forrester zum Thema Kontext-Ebenen nachlesen. Die beiden Definitionen sind miteinander vereinbar. Beide besagen, dass die von Unternehmen für BI geschaffene Ebene nun dazu aufgefordert ist, eine andere Zielgruppe mit unterschiedlichen Anforderungen zu bedienen.
Die Entwicklungen bei den Anbietern verliefen im Jahr 2026 rasant und konzentrierten sich fast ausschließlich auf den strukturierten Bereich. Atlan erweiterte sein Angebot um agentenorientierte Kontextfunktionen. Snowflake brachte „Horizon Context“ und „Cortex Sense“ auf den Markt, Databricks „Genie Ontology“, Microsoft „Fabric IQ“, Glean seinen „Enterprise Graph“, ServiceNow eine „Context Engine“, Pinecone „Nexus“ und Redis „Iris“. Alle setzen aus unterschiedlichen Ausgangspositionen auf dasselbe Ziel: dass Agenten eine geregelte, wiederverwendbare Beschreibung von Unternehmensinformationen benötigen und nicht nur einen direkten Zugriff darauf.
Ein Hinweis, den Analysten und die Fachpresse unumwunden zum Ausdruck gebracht haben: Eine Kontext-Ebene ist kein Produkt, das man einfach kauft und in Betrieb nimmt. Es handelt sich um eine Reihe von Verantwortlichkeiten, die ein Bestandteil Ihrer Architektur übernehmen muss, und die Entscheidung, welche Inhalte maßgeblich sind, wie die Aufbewahrungsregeln lauten und unter welcher Identität ein Agent agiert, ist nicht im Lieferumfang enthalten. Wie sich diese Ebene zu Ihren bestehenden Systemen verhält, erfahren Sie in unserer Sichtweise auf die Suche als KI-Infrastruktur.
Kontext-Ebene, semantische Ebene, Wissensgraph, Ontologie und Kontext-Engineering: Was diese Begriffe jeweils bedeuten
Dies ist die Frage, die in dieser Kategorie am häufigsten gestellt wird, und die im Umlauf befindlichen Antworten sind meist von den Anbietern geprägt. Hier finden Sie eine neutrale Version.
| Term | What it actually is | What it is good at | Where it stops |
|---|---|---|---|
| Semantic layer | A business-friendly abstraction over structured data defining metrics, dimensions, joins, and naming, so „revenue“ means one thing everywhere. | Making numbers consistent and queryable in natural language; stopping two dashboards from disagreeing about the same metric. | It assumes modeled tables underneath. It has nothing to say about a contract PDF, a Jira thread, or a policy manual. |
| Knowledge graph | An instance-level store of actual entities and the relationships between them: this customer, that contract, this incident, linked by typed edges. | Multi-hop traversal: „which contracts reference the clause this incident triggered.“ | Building it over unstructured sources needs accurate extraction, and the graph is only as current as its last extraction run. |
| Ontology | The schema above a graph: the formal definition of entity types, attributes, and permitted relationships. The vocabulary, not the facts. | Enforcing consistency, enabling inference, and letting systems agree on what a „claim“ or a „part“ is. | It answers no questions by itself. It is a contract about meaning, still needing populated data and a retrieval path. |
| Context engineering | The practice, not a system, of deciding what goes into a model’s working context: what to retrieve, how much, in what order, and when to drop it. | Making one agent behave well within a finite context window and a finite budget. | Applied per application, it provides no connectors, permission enforcement, freshness, or audit on its own. |
| Context layer | The governed runtime tier that assembles, filters by entitlement, and serves context to agents across many applications, structured and unstructured alike. | Centralizing retrieval and access decisions so every agent inherits the same policy, freshness, and audit trail. | It will not set your content strategy, resolve conflicting source-of-truth claims, or fix permissions that are wrong in the source system. |
| RAG pipeline | An implementation pattern: retrieve relevant passages, then place them in the prompt before generation. | Grounding one application’s answers in specific content, quickly, with modest engineering. | A technique inside a context layer, not a substitute for one. Most RAG builds have no entitlement model and no audit. |
Die Unterscheidung, die am häufigsten falsch verstanden wird, ist die zwischen der semantischen Ebene und der Kontextebene. Eine semantische Ebene beantwortet die Fragen: „Was bedeutet dieser Begriff, und wie berechne ich ihn korrekt?“ Eine Kontextebene beantwortet die Fragen: „Was sollte diesem Agenten, der im Auftrag dieser Person handelt, gerade jetzt zur Verfügung gestellt werden, und darf ich es ihm zur Verfügung stellen?“ Ersteres ist ein Modellierungsproblem, das zur Entwurfszeit gelöst wird; letzteres ist ein Ausführungsproblem, das zum Zeitpunkt der Anfrage gelöst wird und eine Autorisierungsentscheidung beinhaltet, für die eine semantische Ebene niemals konzipiert wurde. Eine semantische Ebene ist eine Eingabe für eine Kontextebene, nicht deren kleinere Version.
Die zweite Verwechslungsgefahr besteht zwischen Ontologie und Wissensgraph. Die Ontologie ist das Typsystem; der Graph besteht aus den damit konformen, mit Daten gefüllten Instanzen. Ein Graph mit einer schwachen oder impliziten Ontologie ist weit verbreitet, und seine Qualität verschlechtert sich, wenn Teams Kanten hinzufügen, die leicht unterschiedliche Bedeutungen haben. Eine elegante Ontologie, die fast gar nicht mit Daten gefüllt ist, kommt ebenso häufig vor und ist kostspielig. Wenn ein Anbieter von „Ontologie“ spricht, fragen Sie nach, welche der beiden Varianten er tatsächlich liefert.
Der dritte Punkt betrifft das „Context Engineering“ im Gegensatz zu einer „Kontext-Schicht“. Context Engineering ist das, was ein gutes Anwendungsteam innerhalb eines Agenten leistet: das Kürzen, Neugewichten, Zusammenfassen und Ordnen der Beleginformationen. Das ist echte Fachkompetenz. Wenn jedoch jedes Team dies unabhängig voneinander tut, erhalten Sie ein Dutzend unterschiedlicher Antworten auf die Frage „Darf dieser Nutzer dieses Dokument einsehen?“, was genau die Situation ist, die eine Kontextschicht beseitigen soll. Context Engineering ist das Handwerk; die Kontextschicht ist die Grundlage, auf der es läuft.
Die Hälfte der Kategorie, die niemand baut
Liest man die Definitionen strukturierter Daten genau durch, so lässt sich dahinter eine einheitliche Reihe von Annahmen erkennen. Ein verwaltetes Data Warehouse, das bereits von jemandem kuratiert wurde. Modellierte Tabellen mit stabilen Schemata. Zugriffsrichtlinien, die sich als Zeilenfilter und Spaltenmasken ausdrücken lassen, an die Tabelle angehängt sind und von der Abfrage-Engine ausgewertet werden. Daten, die zum Zweck der Abfrage erstellt wurden – weshalb sie überhaupt Typen und Schlüssel besitzen.
Nehmen Sie nun einen 300-seitigen Umsetzungsplan auf einer SharePoint-Website, deren Berechtigungen sich heute Vormittag geändert haben, weil jemand einen Auftragnehmer zu einer Gruppe hinzugefügt hat, die drei Ebenen höher angesiedelt ist. Jede einzelne dieser Annahmen trifft nicht zu.
- Es gibt kein Schema. Das Dokument enthält Abschnitte, Tabellen, Anhänge und ein Diagramm mit Text darin. Es wird an keiner Stelle angegeben, welcher Teil maßgeblich ist oder auf welche Einheit er sich bezieht.
- Die Berechtigungen sind in sechs Systemen hinterlegt und ändern sich stündlich. SharePoint-Gruppen, Verschachtelungen in Active Directory, Beschränkungen für Confluence-Bereiche, ServiceNow-Rollen, ACLs für Dateifreigaben und die eigene Tabelle einer Anwendung. Es gibt keinen einzigen Ort, an dem man nachlesen kann, „wer dies sehen darf“, und es gibt keine Garantie dafür, dass die Antwort auch fünf Minuten später noch gilt.
- Die Bedeutung verteilt sich auf mehrere Passagen. Die Antwort findet sich oft in einem Absatz auf Seite 214, der jedoch nur im Zusammenhang mit einer Definition auf Seite 12 Sinn ergibt. Die Datei zurückzugeben, ist sinnlos; das falsche Fragment zurückzugeben, ist schlimmer als sinnlos.
- Duplikate und verschiedene Versionen sind der Normalzustand. Die gleiche Richtlinie liegt als Entwurf, als genehmigte PDF-Datei, als Wiki-Zusammenfassung und als E-Mail-Anhang vor. Drei davon sind fehlerhaft, und aus dem Inhalt geht nicht hervor, welche.
- Es wurde nie dafür geschrieben, abgefragt zu werden. Es wurde dafür verfasst, einmal von einem Menschen gelesen zu werden, der den Kontext bereits kannte. Pronomen, implizierte Subjekte und interne Abkürzungen sind allgegenwärtig.
All dies lässt sich nicht durch ein besseres Einbettungsmodell beheben. Die Lösung besteht in einer Serviceschicht, die Daten aus den Quellsystemen bezieht, die Zugriffsregeln für jeden Eintrag mitführt, beides auf dem neuesten Stand hält, Inhalte in sinngemäße Abschnitte unterteilt und die Zugriffsberechtigung bei jeder Anfrage – und nicht erst zum Zeitpunkt der Indizierung – überprüft. Genau diese Aufgabe erfüllt Lucidworks unter dem Namen „AI Context Data Platform“, die auf den unstrukturierten Teil des Problems angewendet wird und die Grundlage unserer Lösungen für das Wissensmanagement in Unternehmen bildet.
Welche Aufgabe eine Kontextschicht für unstrukturierte Inhalte erfüllt
Lässt man die vom Anbieter vorgegebene Rahmenkonzeption außer Acht, lassen sich die funktionalen Anforderungen auf sechs Aufgaben reduzieren, die in der Erstellungsreihenfolge nacheinander ablaufen, zur Laufzeit jedoch gleichzeitig ausgeführt werden.
Verbinden. Führen Sie alle Quellen zusammen – von SharePoint und Confluence bis hin zu ServiceNow und Dateifreigaben. Jeder Konnektor muss inkrementelle Änderungen, Löschungen, Drosselungen sowie die spezifischen Identitätskonzepte der jeweiligen Quellsysteme berücksichtigen. Inhalte, die nicht eingebunden sind, sind Inhalte, auf die Ihre Mitarbeiter auch ohne diese Informationen sicher antworten können. Unser Ansatz wird unter den Rubr iken „Datenerfassung“ und „Konnektoren“ beschrieben.
Sicher. Berechtigungen sind an den Inhalt gebunden. Zugriffsregeln sind jedem Dokument zugeordnet und werden bei jeder Abfrage überprüft. Der Bearbeiter sieht genau das, was die anfragende Person sehen darf, und nicht eine Momentaufnahme dessen, was diese zum Zeitpunkt der Indexerstellung sehen konnte. Dies ist die anspruchsvollste Anforderung in diesem Zusammenhang und diejenige, die durch Definitionen strukturierter Daten von der Abfrage-Engine übernommen wird.
Bereichern. Finden Sie die Passage, nicht nur die Datei. Der Inhalt wird in sinnvolle Passagen unterteilt, sodass der Bearbeiter den Absatz erhält, der die Frage beantwortet, anstatt ein 200-seitiges PDF. Eine gute Aufteilung berücksichtigt die Dokumentstruktur, enthält genügend Kontext, damit eine Passage für sich allein stehen kann, und enthält einen Verweis auf die genaue Stelle für Zitierzwecke.
Suchen. Genaue Begriffe und Bedeutung – beides zusammen. Unternehmensanfragen enthalten beides: eine Artikelnummer, einen Richtliniencode oder eine Fehlermeldung, die exakt übereinstimmen müssen, sowie eine Absicht, die nur durch eine Vektorsuche erfasst werden kann. Die „Neural Hybrid Search“ sucht sowohl nach Schlüsselwörtern als auch nach der Absicht, weshalb die reine Vektorsuche bei den Suchanfragen, die für Unternehmen am wichtigsten sind, enttäuschende Ergebnisse liefert.
Boden. Fakten, keine Vermutungen. Jede Antwort basiert auf geprüften Inhalten und enthält Quellenangaben. Diese Fundierung ist zum Teil eine Frage der Informationsgewinnung und zum Teil eine Frage der Richtlinien: Die Ebene muss wissen, welche Inhalte maßgeblich sind und welche veraltete Entwürfe darstellen, und diese Unterscheidung für den Agenten sichtbar machen.
Liefern. Die richtige Antwort oder die richtige Maßnahme im Rahmen der Richtlinien. Was abgefragt, angezeigt und beantwortet wurde, bleibt in den Aufzeichnungen festgehalten. Für regulierte Käufer sind diese Aufzeichnungen das Dokument, das ein Prüfer anfordert, und sie müssen die Berechtigungsentscheidung widerspiegeln, nicht nur den zurückgegebenen Text.
Inwiefern dies mit RAG zusammenhängt und warum sich das Modell von „Push“ zu „Pull“ verlagert
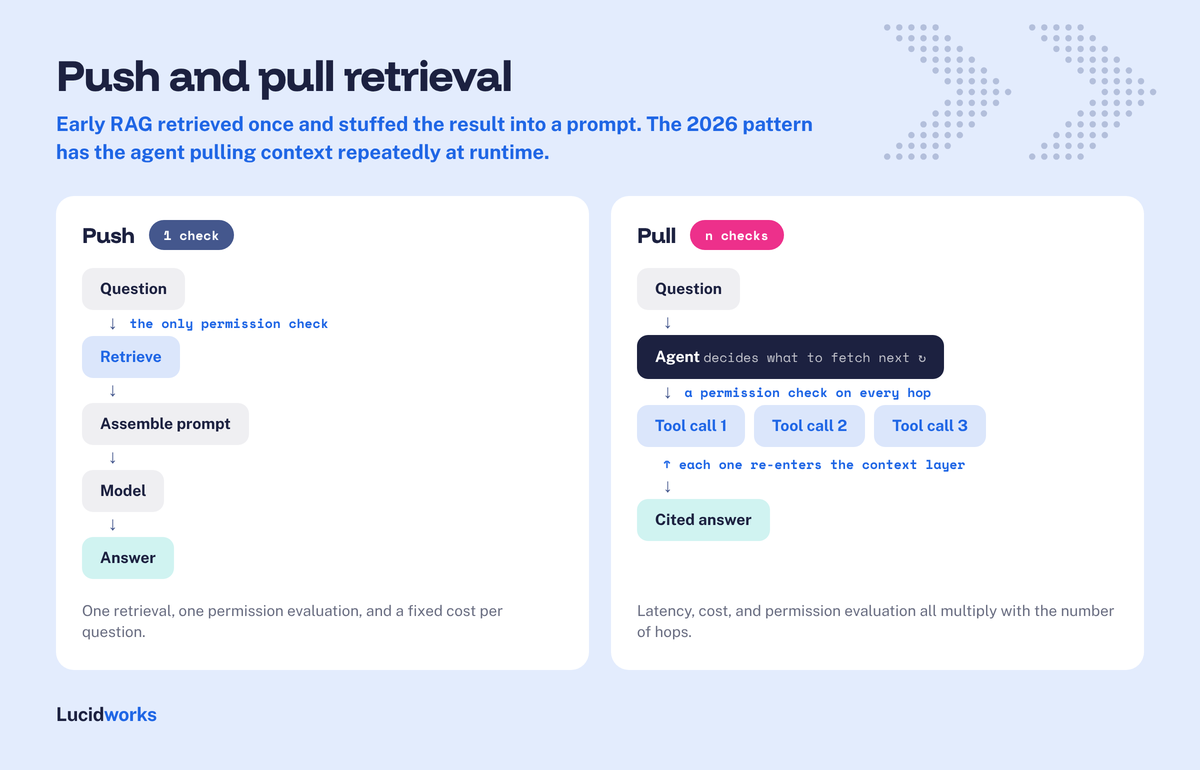
Die frühe RAG-Architektur basierte auf einem „Push“-Ansatz. Die Anwendung legte vor der Generierung fest, was das Modell sehen sollte: eine Abfrage durchführen, die relevantesten Passagen auswählen, diese in die Eingabezeile einfügen und generieren. Das Modell war ein passiver Empfänger eines Pakets, das von jemand anderem zusammengestellt worden war. Dieses Muster eignet sich nach wie vor für eng gefasste Anwendungen mit einer vorhersehbaren Fragenstruktur.
Das Muster für 2026 ist „Pull“. Der Agent verfügt über Werkzeuge, entscheidet zur Laufzeit, was abgerufen werden soll, liest die zurückgegebenen Ergebnisse und entscheidet, was als Nächstes abgerufen werden soll. Das Abrufen erfolgt nicht mehr als einzelner Schritt vor der Generierung, sondern ist eine Schleife, die mit dem Schlussfolgern verflochten ist. Ein Agent, der eine Support-Eskalation bearbeitet, könnte die Wissensdatenbank durchsuchen, einen Artikel lesen, den Berechtigungsdatensatz des Kunden nachschlagen und anschließend erneut anhand von Begriffen suchen, die er erst aus dem ersten Ergebnis gelernt hat.
Bei dieser Umstellung ändern sich drei Dinge, und alle drei betreffen die Kontextebene, nicht das Modell.
- Der Abruf erfolgt mehrmals pro Aufgabe. Eine Benutzeranfrage kann zehn oder dreißig Abrufvorgänge auslösen. Alles, was Sie bisher einmal pro Anfrage erledigt haben, müssen Sie nun dreißig Mal erledigen.
- Verzögerung und Kosten summieren sich. Eine Abrufzeit von 400 ms ist einmal in Ordnung, aber dreißig Mal hintereinander inakzeptabel. Pull macht die Abrufleistung zu einer Produktanforderung und nicht zu einem Detail der Infrastruktur.
- Bei jedem Hop werden Berechtigungsprüfungen durchgeführt. Beim „Push“-Verfahren könnten Sie unbedacht einmalig eine Berechtigung erteilen und dem Paket vertrauen. Beim „Pull“-Verfahren entscheidet der Agent, wohin es als Nächstes geht, sodass jeder Schritt eine neue Zugriffsentscheidung darstellt, die für denjenigen getroffen wird, in dessen Auftrag der Agent handelt.
Dieser letzte Punkt verdeutlicht das ungelöste Problem in dieser Kategorie: die Identität des Agenten. Wenn ein Agent ein Tool aufruft, das wiederum einen anderen Agenten aufruft, der ein Repository abfragt, muss die Frage „Wessen Berechtigungen gelten hier?“ bei jedem Schritt erhalten bleiben. Die meisten Systemarchitekturen reduzieren dies entweder auf ein einziges Dienstkonto (was zwar praktisch ist, aber ein erhebliches Risiko einer übermäßigen Berechtigungsvergabe birgt) oder führen an jeder Grenze eine erneute Authentifizierung durch, ohne dass ein gemeinsames Verständnis des ursprünglichen Prinzipals besteht. Niemand hat das Problem der delegierten Identität über verschiedene Schichten hinweg vollständig gelöst, und ein Anbieter, der etwas anderes behauptet, beschreibt lediglich eine Roadmap.
Wo MCP geeignet ist – und wo nicht
Das Model Context Protocol ist das wichtigste Grundgerüst in diesem Stack und zugleich das am häufigsten missverstandene. MCP ist ein Standard für den Transport und den Aufruf von Tools: Es legt fest, wie ein Agent Tools und Ressourcen erkennt, wie er diese aufruft und wie die Ergebnisse zurückgegeben werden. Es ist die weit verbreitete Basis, und die Standardisierung auf dieses Protokoll ist die richtige Entscheidung. Wir haben einen ausführlicheren Leitfaden darüber verfasst, was das Model Context Protocol ist und warum es für KI in Unternehmen von Bedeutung ist.
Was MCP nicht tut, ist zu definieren, was sich auf der anderen Seite des Aufrufs befindet. Es standardisiert, wie ein Agent eine Anfrage stellt, nicht jedoch, was zurückkommt, ob dieser Inhalt aktuell ist, ob er verbindlich ist oder ob der Anfragende berechtigt ist, ihn einzusehen. Ein MCP-Server, der auf einen unkontrollierten Index verweist, stellt keine Architektur dar. Er ist ein Sicherheitsrisiko mit einer Standardschnittstelle: ein maschinell auffindbarer Pfad zu jedem Dokument, dessen Zugriffsbeschränkung jemand versäumt hat. Das Protokoll tut genau das, was es versprochen hat. Die Governance war schon immer die andere Hälfte.
Drei damit zusammenhängende Standards sind ab Ende 2026 besonders zu beachten. A2A erreichte im April 2026 unter der Schirmherrschaft der Linux Foundation die Version 1.0 und führte signierte „Agent Cards“ ein – ein erster glaubwürdiger Schritt hin zu Agenten, die überprüfbare Angaben darüber machen, was sie sind und wer sie betreibt. WebMCP befindet sich auf dem W3C-Standardisierungsprozess und weist auf eine Zukunft hin, in der Webanwendungen Agenten nativ Tools zur Verfügung stellen. Open Semantic Interchange ging im Januar 2026 mit Snowflake, Salesforce, Tableau und dbt Labs als Gründungspartnern an den Start und zielt auf portierbare semantische Definitionen ab. OSI ist eindeutig auf strukturierte Daten ausgerichtet; es gibt kein Äquivalent für unstrukturierte Inhalte oder für Berechtigungen, was eine erwähnenswerte Lücke darstellt.
Die Arbeitsteilung ist klar. MCP ist die Art und Weise, wie der Agent eine Anfrage stellt. Die Kontextschicht ist das, was antwortet und entscheidet, ob überhaupt eine Antwort erfolgt. Unsere Implementierung des Ersteren ist der Lucidworks MCP-Server, der so konzipiert ist, dass Berechtigungen und Herkunft hinter dem Protokoll abgewickelt werden, anstatt vom Protokoll einfach vorausgesetzt zu werden.
Was Sie vor dem Kauf beachten sollten
Jede der folgenden Fragen lässt sich mit einem bestimmten Mechanismus beantworten. Sollte die Antwort in Form einer philosophischen Betrachtung erfolgen, betrachten Sie diese bitte als die Antwort.
- Wie erhalten Sie Berechtigungen von den einzelnen Quellsystemen, und wie schnell wirkt sich eine Änderung der Berechtigungen im Quellsystem auf die Suchergebnisse aus?
- Wird die Berechtigungsprüfung zum Zeitpunkt der Abfrage für den anfragenden Benutzer durchgeführt oder bereits zum Zeitpunkt der Indizierung vorgenommen und zwischengespeichert?
- Wenn ein Agent im Namen einer Person anruft, wie wird diese Identität weitergegeben, und was geschieht bei einem Anruf mit mehreren Zwischenstationen über einen anderen Agenten?
- Welche Konnektoren bieten Sie an, welche unterstützen inkrementelle Änderungen und Löschungen, und welche basieren auf einem generischen Crawler?
- Wie wird der Text in Abschnitte unterteilt, und können Sie mir die genauen Abschnittsgrenzen sowie den Quellenverweis hinter einer bestimmten Antwort anzeigen?
- Wird bei der Suche eine exakte Stichwortübereinstimmung mit einer Vektorsuche kombiniert, und kann ich für jede einzelne Suchanfrage nachverfolgen, welches Signal zu welchem Ergebnis geführt hat?
- Wie hoch ist Ihre P95-Abrufverzögerung bei einer agentischen Auslastung von zwanzig oder mehr Anrufen pro Benutzeraufgabe, und wie wird dies berechnet?
- Was genau wird in das Prüfprotokoll eingetragen: die Anfrage, die berücksichtigten Unterlagen, die zurückgesendeten Unterlagen, die Entscheidung über den Anspruch oder alle vier?
- Wie unterscheiden Sie maßgebliche Inhalte von veralteten Entwürfen und Beinahe-Duplikaten, und wird diese Unterscheidung dem Agenten offengelegt?
- Wo werden die Inhalte gespeichert und wo werden sie verarbeitet, und kann das gesamte System innerhalb unserer Grenzen betrieben werden, falls unsere Aufsichtsbehörde dies verlangt?
Häufig gestellte Fragen
Ist eine Kontextebene dasselbe wie eine semantische Ebene?
Nein. Eine semantische Ebene definiert, was Geschäftsbegriffe bedeuten und wie sie anhand modellierter Daten berechnet werden, und zwar größtenteils bereits in der Entwurfsphase. Eine Kontext-Ebene stellt Inhalte bei Anforderung zusammen, stellt sie den Agenten bereit und trifft im Rahmen dieses Dienstes eine Autorisierungsentscheidung. Eine semantische Ebene ist eine nützliche Eingabe für eine Kontext-Ebene, deckt jedoch weder unstrukturierte Inhalte noch Laufzeitberechtigungen ab.
Benötige ich eine Kontext-Ebene, wenn ich bereits Snowflake oder Databricks nutze?
Ehrlich gesagt benötigen Sie wahrscheinlich beides. Snowflake Horizon Context, Cortex Sense und Databricks Genie Ontology lösen den strukturierten Teil gut – und zwar für Daten, die auf diesen Plattformen bereits geregelt sind. Sie berücksichtigen jedoch nicht die Dokumente, Tickets, Wikis und Verträge in SharePoint, Confluence, ServiceNow und Dateifreigaben, bei denen die Zugriffsrechte außerhalb des Data Warehouse liegen und sich ständig ändern. Die meisten Unternehmen bedienen ihre Mitarbeiter letztendlich aus beiden Systemen heraus, weshalb es sich lohnt, die Frage der Integration – wie sich beide Systeme hinsichtlich Identität und Richtlinien abstimmen – frühzeitig zu klären.
Kann ich einfach MCP verwenden?
MCP löst das Verbindungsproblem, nicht das Governance-Problem. Es standardisiert, wie ein Agent Tools erkennt und aufruft; es sagt nichts darüber aus, ob die Inhalte hinter einem Tool aktuell, verbindlich oder für den Anfragenden zulässig sind. Wenn Sie einen MCP-Server auf einen Index ohne Berechtigungsmodell verweisen, haben Sie lediglich dafür gesorgt, dass Agenten leichter auf unkontrollierte Inhalte zugreifen können. Führen Sie MCP ein und stellen Sie sicher, dass eine dahinterstehende Instanz die Verantwortung für den Zugriff und die Herkunft übernimmt.
Ist eine Kontext-Ebene dasselbe wie RAG?
Nein. RAG ist ein Muster für die Abrufung und Generierung von Informationen, das von einer Anwendung implementiert wird. Eine Kontextschicht ist eine gemeinsam genutzte Ebene, auf die viele Anwendungen zugreifen, einschließlich Konnektoren, Berechtigungsdurchsetzung, Aktualitätsprüfung und Protokollierung – Funktionen, über die eine typische RAG-Implementierung nicht verfügt. RAG ist eine Technik, die innerhalb einer Kontextschicht zum Einsatz kommt.
Benötigt eine Kontext-Ebene einen Wissensgraphen?
Nicht unbedingt. Ein Graph ist zwar hilfreich bei Fragen zu Beziehungen über mehrere Ebenen hinweg und beim quellenübergreifenden Schlussfolgern auf Entitätsebene, verursacht jedoch erhebliche Einbußen hinsichtlich der Extraktionsgenauigkeit und der Pflege; ein veralteter Graph ist zudem schlechter als gar kein Graph. Treffen Sie Ihre Entscheidung danach, ob die Fragen Ihrer Nutzer tatsächlich eine Graphdurchquerung erfordern, und nicht danach, ob ein Graph in der Referenzarchitektur vorgesehen ist.
Was versteht man unter „Context Engineering“, und handelt es sich dabei um dasselbe?
Unter „Context Engineering“ versteht man die anwendungsspezifische Vorgehensweise, bei der für eine bestimmte Aufgabe festgelegt wird, welche Elemente in den Arbeitskontext eines Modells aufgenommen werden sollen: welche Daten abgerufen werden sollen, in welchem Umfang, in welcher Reihenfolge und welche Daten verworfen werden sollen. Eine Kontextschicht ist die gemeinsame Infrastruktur, auf der die Disziplin basiert, sodass nicht jedes Team unabhängig davon neu entwickeln muss, wie Zugriffsentscheidungen getroffen werden.
Ist das etwas, das ich kaufe, oder etwas, das ich selbst baue?
Beides. Kaufen Sie die Konnektoren, die Abruf-Engine, die Durchsetzung von Zugriffsrechten und den Prüfpfad, denn diese Komponenten sind komplex, generisch und in der Wartung kostspielig. Was Sie nicht kaufen können, ist die Entscheidung darüber, welche Inhalte maßgeblich sind, wie lange sie aufbewahrt werden und unter welcher Identität ein Mitarbeiter in Ihrem Unternehmen handelt. Anbieter, die eine Kontextschicht als einen Schalter präsentieren, den man einfach umlegt, lassen den Teil außer Acht, der darüber entscheidet, ob das Programm funktioniert.