
Sechs Schritte von verstreuten Informationen zu einer Antwort, die Sie verteidigen können
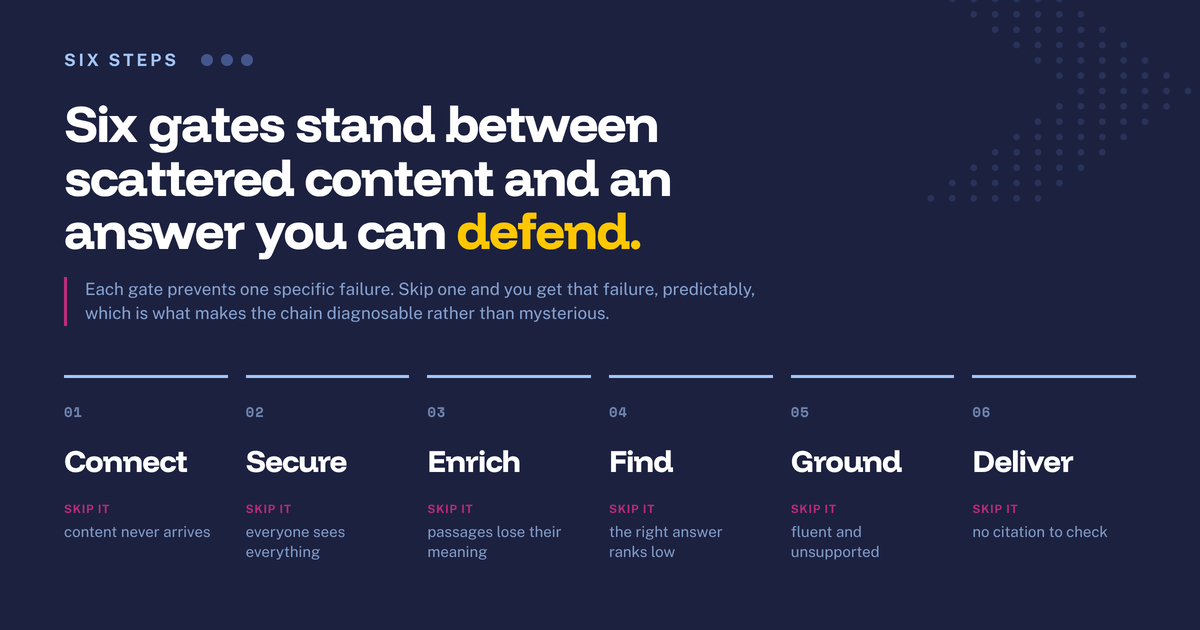
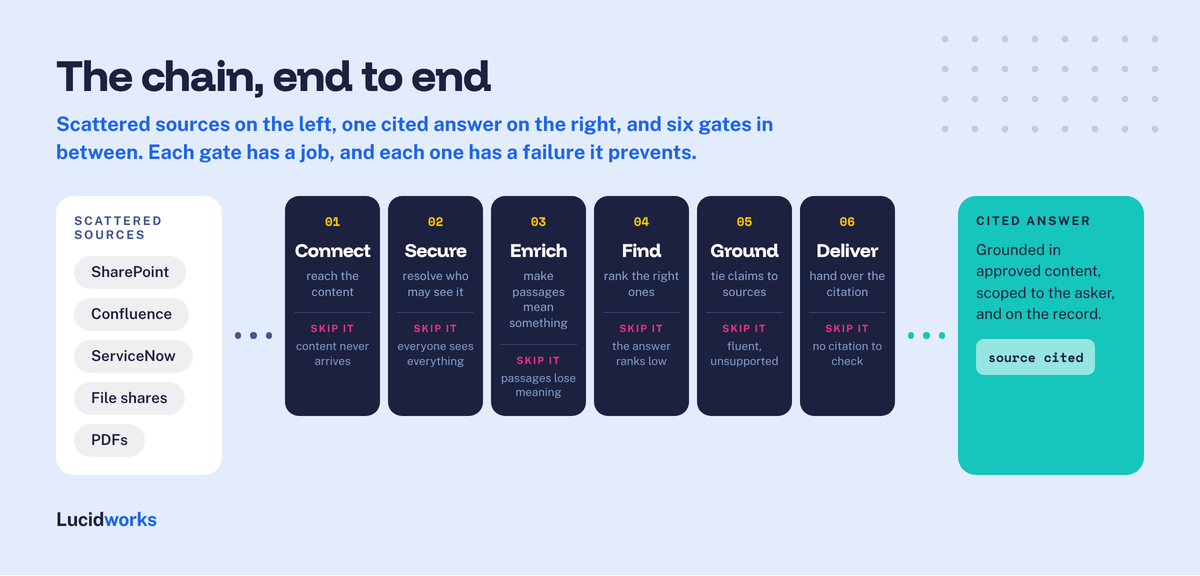
Um aus verstreuten Unternehmensinhalten eine Antwort zu gewinnen, die ein Mitarbeiter verteidigen kann, sind sechs Schritte erforderlich, und zwar in dieser Reihenfolge: Verbinden, Sichern, Anreichern, Finden, Verankern und Bereitstellen. Dies sind die Funktionselemente einer Kontextschicht, die hier als Abfolge und nicht als Kategorie dargestellt werden. Jeder Schritt erfüllt eine Aufgabe, von der der nächste abhängt; das Überspringen eines Schritts führt daher nicht zu einer geringfügig schlechteren Antwort, sondern zu einem konkreten, vorhersehbaren Fehlschlag.
| Step | What it does | What it prevents |
|---|---|---|
| 1. Connect | Brings every source together, from SharePoint and Confluence to ServiceNow and file shares, reaching content where it lives. | Answers drawn from a partial view of the organization, confidently given and quietly incomplete. |
| 2. Secure | Permissions travel with the content. Access rules come along with every document and are checked each time someone asks. | An agent that answers correctly from a document the person asking was never allowed to open. |
| 3. Enrich | Finds the passage, not just the file. Content is split into meaningful passages, so the agent gets the paragraph that answers the question. | Retrieval that returns a 200-page PDF and leaves the real work to the reader. |
| 4. Find | Matches exact terms and meaning together, so a part number and a plain English question both reach the right content. | A system that handles one query style well and silently fails the other. |
| 5. Ground | Builds every answer from approved content and cites the specific passages it came from. | Fluent answers that nobody can trace, verify, or defend. |
| 6. Deliver | Returns the right answer, or takes the right action, within policy. What was asked, shown, and answered stays on the record. | Agent activity that cannot be reconstructed when a regulator or an auditor asks what happened. |
Schritt 1: Verbinden
„Connect“ bedeutet, alle Quellen zusammenzuführen – von SharePoint und Confluence bis hin zu ServiceNow und Dateifreigaben. In den meisten Unternehmen ist diese Liste länger, als man vermuten würde: ein Dokumentenmanagementsystem, ein Fallmanagementsystem, ein Vertragsarchiv, ein Wiki, ein Ticketingsystem, ein E-Mail-Archiv sowie mehrere Netzlaufwerke, die bereits vor der Gründung der aktuellen IT-Abteilung existierten.
Technisch gesehen geht es hier um Schnittstellen und die Erfassung von Änderungen, nicht um Migration. Die Aufgabe besteht darin, Inhalte dort abzurufen, wo sie sich befinden, Ergänzungen, Bearbeitungen und Löschungen in Echtzeit zu erkennen und sehr unterschiedliche Formate so zu vereinheitlichen, dass ein Abrufsystem damit arbeiten kann. Ein gescanntes PDF, eine Confluence-Seite, eine .msg-Datei und ein ServiceNow-Artikel müssen alle in einer vergleichbaren Form vorliegen und dabei ihre Metadaten sowie ihre Zugriffsrechte beibehalten. Insbesondere die Zugriffsrechte sind entscheidend, da Schritt zwei davon abhängt.
Der Fehler, den dies verhindert, ist der häufigste bei KI-Pilotprojekten in Unternehmen: Ein Chatbot, der autoritär klingt, während er nur einen Bruchteil der Unternehmensinformationen vorliest. Ein Pilotprojekt, das auf das Wiki indexiert ist, beantwortet Fragen anhand der Informationen aus dem Wiki – einschließlich solcher Fragen, bei denen das Wiki sechs Monate hinter dem offiziellen Datensystem zurückliegt. Niemand bemerkt diese Lücke. Man nimmt lediglich eine falsche Antwort wahr, die im gleichen ruhigen Tonfall wie eine richtige Antwort vorgetragen wird.
Konkret: Ein Supportmitarbeiter fragt, ob es sich bei dem Problem eines Kunden um einen bekannten Fehler handelt. Die Liste der bekannten Fehler befindet sich im Engineering-Tracker. Wenn der Tracker nie angebunden wurde, antwortet der Mitarbeiter anhand der Versionshinweise und verneint dies. Der Zugriff auf die Quellen, an denen diese Informationen bereits vorliegen – über die unternehmensweite Datenerfassung –, ist es, was den weiteren Ablauf der Kette erst ermöglicht.
Schritt zwei: Befestigen
„Sicher“ bedeutet, dass die Berechtigungen mit den Inhalten mitwandern. Zu jedem Dokument gehören Zugriffsregeln, die bei jeder Abfrage überprüft werden, sodass der Bearbeiter genau sieht, was die anfragende Person einsehen darf.
Das entscheidende Wort ist „jedes“. Es gibt zwei Möglichkeiten, den Zugriff in einem Abrufsystem zu handhaben, und nur eine davon ist tragfähig. Die erste filtert nachträglich: Es wird zunächst ein breiter Abruf durchgeführt, anschließend werden die Ergebnisse entfernt, die der Benutzer nicht sehen darf. Die zweite Methode überträgt die Zugriffskontrollliste (ACL) jedes Dokuments bereits bei der Erfassung zusammen mit dem Inhalt, ermittelt zum Zeitpunkt der Abfrage die Gruppenzugehörigkeiten des anfragenden Nutzers und schränkt die Suche selbst anhand dieser Berechtigungen ein. Die erste Methode weist Sicherheitslücken auf, da alles, was das Ergebnis vor dem Ausführen des Filters beeinflusst, das Ergebnis bereits geprägt hat. Die zweite Methode bedeutet, dass ein nicht zugängliches Dokument überhaupt keinen Beitrag leisten kann, da es nie als Kandidat in Betracht kam.
Auch dies muss Veränderungen standhalten. Mitarbeiter wechseln das Team, Bereiche werden abgegrenzt, ein Projektteam unterliegt Zugangsbeschränkungen, ein Mitarbeiter verlässt das Unternehmen. Werden Berechtigungen einmalig zum Zeitpunkt der Indizierung ermittelt und zwischengespeichert, ist das System am Tag seiner Erstellung korrekt, wird danach jedoch zunehmend ungenau. Die Überprüfung bei jeder Abfrage anhand der aktuellen Gruppenzugehörigkeit ist die einzige Methode, die stets korrekte Ergebnisse liefert.
Die Identität des Agenten ist branchenweit der wirklich ungeklärte Aspekt. Wenn ein Agent im Namen einer anderen Person handelt – und insbesondere, wenn er einen anderen Agenten aufruft –, muss bei jedem Schritt klar sein, welche Berechtigungen gelten. Betrachten Sie jedes System, das Ihnen nicht mitteilen kann, wessen Berechtigungen bei einem bestimmten Aufruf durchgesetzt wurden, als unvollständig.
Schritt 3: Anreichern
„Enrich“ bedeutet, den entsprechenden Abschnitt zu finden, nicht nur die Datei. Der Inhalt wird in sinnvolle Abschnitte unterteilt, sodass der Mitarbeiter den Absatz erhält, der die Frage beantwortet, anstatt ein 200-seitiges PDF.
Der Unterschied besteht zwischen der Suche auf Passageebene und der Suche auf Dokumentebene. Bei der Dokumentensuche wird eine Datei als Einheit betrachtet: Das System entscheidet, dass das Plandokument relevant ist, und liefert dieses aus. Bei der Suche auf Passagenebene wird ein Textabschnitt als Einheit betrachtet, sodass das System feststellen kann, dass es sich bei der Frage um Abschnitt 7.4.2 handelt – drei Absätze auf einer einzigen Seite. Für einen Menschen, der über ausreichend Zeit verfügt, ist die Suche auf Dokumentebene lediglich lästig. Für einen Agenten, der innerhalb eines Kontextfensters arbeitet, bedeutet dies jedoch den Unterschied zwischen einer brauchbaren Antwort und einer Zusammenfassung des Falschen, da ein Modell bei einem langen Dokument eher die thematisch ähnlich erscheinenden Teile berücksichtigt als die für den Kontext maßgeblichen.
Dies gut zu bewerkstelligen ist schwieriger als eine Aufteilung nach einer festen Zeichenanzahl. Eine Aufteilung in Blöcke fester Größe halbiert Tabellen, trennt einen Satz von der Definition, auf die er sich bezieht, und entfernt Überschriften, die den einzigen Hinweis darauf enthalten, auf welches Produkt oder welche Rechtsordnung sich ein Abschnitt bezieht. Strukturorientierte Ansätze wie das KI-basierte Chunking nehmen die Aufteilung entlang der dokumenteneigenen Grenzen vor und übertragen den umgebenden Kontext mit, sodass ein extrahierter Textabschnitt weiterhin erkennbar ist, zu welchem Gesamtkontext er gehört.
Die Anreicherung umfasst auch Metadaten: Gültigkeitsdaten, Dokumentstatus, Rechtsgebiet und Version. Eine Passage, bei der nicht feststellbar ist, ob sie aktuell ist, ist eine Passage, auf die Sie eine Antwort nicht stützen können.
Schritt vier: Finden Sie
„Find“ bedeutet, genaue Begriffe und deren Bedeutung gemeinsam zu ermitteln. Dies ist ein Schritt statt zwei, da Unternehmensanwender beide Arten von Fragen stellen – oft innerhalb derselben Stunde –, und ein System, das auf die eine Art abgestimmt ist, versagt stillschweigend bei der anderen.
Genaue Identifikatoren erfordern eine wörtliche Übereinstimmung. Eine Teilenummer, eine Versicherungsnummer, eine Formularnummer, ein Verfahrenscode, ein Gesetzesverweis oder eine interne Dokument-ID weisen keine sinnvolle semantische Umgebung auf. Eine nahezu übereinstimmende Kennung stellt keinen Teilerfolg dar; es handelt sich vielmehr um eine eindeutige Antwort auf eine andere Sache. Der Abgleich anhand von Schlüsselwörtern und lexikalischen Merkmalen behandelt dies korrekt, da er nach der Zeichenfolge und nicht nach dem Konzept sucht.
Fragen in natürlicher Sprache erfordern das Gegenteil. „Kann ein Kunde dies in einem Altersvorsorgekonto halten?“ hat fast keine gemeinsamen Begriffe mit dem Absatz, der diese Frage beantwortet, in dem von qualifizierten Konten, zulässigen Beständen und erlaubten Anlageinstrumenten die Rede ist. Die Vektorsuche bewältigt dies durch den Vergleich von Embeddings, also numerischen Darstellungen von Bedeutungen, sodass verwandte Ideen unabhängig von der Wortwahl nahe beieinander liegen.
Beides auszuführen und die Ergebnisse zu kombinieren, ist das, was die neuronale Hybridsuche leistet. Der technische Kern liegt in der Kombination: Wie die Ergebnisse der einzelnen Methoden gegeneinander bewertet werden und wie sich das Gleichgewicht je nach Ausgestaltung der Suchanfrage verschiebt. Eine Suchanfrage, die größtenteils aus einer Kennung besteht, sollte den lexikalischen Abgleich stark gewichten, eine dialogorientierte Frage hingegen den semantischen Abgleich. Die meisten realen Suchanfragen sind eine Mischung, wie beispielsweise „Ist das Formular 1099-B hierfür erforderlich?“. Testen Sie beide Ansätze gezielt. Teams, die ihre Systeme ausschließlich anhand von Fragen in natürlicher Sprache bewerten, liefern Systeme aus, die eine Teilenummer nicht finden können – und dies erst bemerken, wenn ein Nutzer es versucht.
Schritt 5: Boden
„Ground“ bedeutet Wahrheit, nicht Vermutungen. Jede Antwort basiert auf geprüften Inhalten und enthält Quellenangaben. In der Praxis bedeutet dies zwei Verpflichtungen: die Einschränkung der Quellen, aus denen das Modell seine Antworten beziehen darf, und die Angabe der Herkunft der von ihm erzeugten Ergebnisse.
Die Einschränkung steht an erster Stelle. Ein fundiertes System liefert Antworten auf der Grundlage der in den vorherigen Schritten abgerufenen Textstellen, und wenn diese Textstellen keine Antwort enthalten, gibt es dies an, anstatt die Lücke mit Trainingsdaten zu füllen. „Ich konnte hierzu keine Hinweise finden“ ist eine korrekte und nützliche Antwort. Ein aus Allgemeinwissen zusammengestellter, plausibler Absatz ist weder das eine noch das andere und auf den ersten Blick nicht von einer echten Antwort zu unterscheiden.
Die Herkunftsangabe ist die andere Hälfte. Eine aussagekräftige Quellenangabe identifiziert nicht nur das Dokument, sondern auch die konkrete Passage: den Abschnitt, die Seite, den Satz sowie die Fassung oder das Datum des Inkrafttretens, aus der bzw. dem sie stammt. „Siehe Mitarbeiterhandbuch“ ist eine bloße Geste. „Abschnitt 4.3 des Handbuchs, gültig ab März 2026“ ist etwas, das eine Person in zehn Sekunden überprüfen kann und das ein Prüfer später nachverfolgen kann. Der praktische Test besteht darin, ob jemand die Frage „Zeigen Sie mir, was der Mitarbeiter gesehen hat“ beantworten kann, ohne ein Support-Ticket einreichen zu müssen.
Die Verankerung ist auch der Ort, an dem die Gültigkeit durchgesetzt wird. Sind sowohl eine abgelöste Richtlinie als auch deren Nachfolger abrufbar, muss das System der aktuellen Version den Vorrang geben und dies deutlich machen, wenn es einen historischen Bezug angibt – was durch die Metadatenarbeit in Schritt drei ermöglicht wird. Der Fehler, den all dies verhindert, ist subtil, und genau das macht ihn so gefährlich. Nicht fundierte Antworten sind flüssig formuliert, gut formatiert und oft korrekt – genau das Profil, dem monatelang vertraut wird, bevor jemand eine solche Antwort überprüft.
Schritt 6: Auslieferung
„Liefern“ bedeutet, im Rahmen der Richtlinien die richtige Antwort oder die richtige Maßnahme zu geben. Was gefragt, gezeigt und beantwortet wurde, bleibt in den Akten vermerkt.
Ein System kann drei unterschiedliche Dinge liefern, und diese als ein einziges zu betrachten, ist ein häufiger Fehler bei der Konzeption. Das erste ist die Rückgabe von Dokumenten: eine nach Relevanz geordnete Liste, deren Interpretation dem Nutzer überlassen bleibt. Das ist die Suche – nach wie vor die richtige Ausgabe für explorative Arbeiten, bei denen jemand einen Überblick über das Vorhandene benötigt. Zweitens die Bereitstellung einer fundierten Zusammenfassung: eine synthetisierte Antwort mit Verweisen auf die herangezogenen Textstellen – genau dann, wenn die Frage eine Antwort hat und die Belege mitgeliefert werden müssen. Drittens die Durchführung einer Maßnahme im Rahmen der Richtlinien: das Eröffnen eines Tickets, das Verfassen einer Antwort, das Aktualisieren der Akte oder die Weiterleitung des Falls. Hier ändern sich die Herausforderungen, denn eine Maßnahme hat Auswirkungen, die eine falsche Antwort nicht hat.
Handlungen erfordern politische Grenzen außerhalb des Modells: Was dieser Agent tun darf, in wessen Auftrag, bis zu welcher Schwelle und was einer menschlichen Genehmigung bedarf. Diese Grenzen gehören in die Ebene, die der Agent aufruft, und nicht in eine Eingabeaufforderung, da Eingabeaufforderungen Vorschläge sind, die Durchsetzung von Richtlinien hingegen nicht.
Protokolle spielen hier eine wichtige Rolle. Das Model Context Protocol (MCP) ist der weithin unterstützte Standard dafür, wie Agenten zur Laufzeit über Tool-Aufrufe Kontext abrufen, und Agent2Agent (A2A) erreichte im April 2026 unter der Schirmherrschaft der Linux Foundation mit signierten Agent Cards die Version 1.0. Beide spiegeln die Neuausrichtung von 2026 wider, weg vom „Push“-Prinzip hin zum „Pull“-Prinzip: Agenten rufen Kontext erst dann ab, wenn sie ihn benötigen, anstatt ihn bereits im Voraus in eine Eingabeaufforderung einfügen zu lassen. Dann die Protokollierung: Jede Frage, jeder abgerufene Textabschnitt, jede Antwort und jede Aktion wird mit der Identität protokolliert, unter der sie ausgeführt wurde. Ein Agent, dessen Aktivitäten nicht rekonstruiert werden können, darf nicht in einen regulierten Prozess eingebunden werden.
Was geht schief, wenn Sie einen Schritt überspringen?
Das Rahmenkonzept lässt sich rückwärts leichter im Gedächtnis behalten. Jeder Schritt existiert aufgrund eines bestimmten Fehlers, und dieser Fehler tritt zuverlässig auf, wenn der Schritt fehlt. Dabei handelt es sich nicht um Ausnahmefälle, sondern um das normale Ergebnis.
| Skipped step | What you get instead |
|---|---|
| Connect | An agent that is confident and partial. It answers from whatever happened to be indexed, with no signal that the authoritative source was never in scope. |
| Secure | An agent that answers correctly from a document the person asking was never allowed to open. Worse than no answer at all, because the exposure stays invisible until someone notices, and by then it has happened many times. |
| Enrich | An agent that hands back a 300-page document and calls it an answer, or summarizes the document’s general theme instead of the one clause that governs the question. |
| Find | A system that works beautifully in the demo and fails on real traffic, because the demo used conversational questions and real users paste part numbers. |
| Ground | Fluent answers nobody can check. Right often enough to be trusted and wrong often enough to be dangerous, with no way to tell which is which without redoing the work. |
| Deliver | Agent activity you cannot reconstruct. When someone asks what the agent saw and why it acted, the honest answer is that nobody knows. |
Die gleichen sechs Schritte in drei regulierten Branchen
Die einzelnen Schritte unterscheiden sich nicht je nach Branche. Was sich ändert, ist, welcher Ausfall die höchsten Kosten verursacht und wie die Nachweise aussehen müssen. Die folgenden Szenarien dienen der Veranschaulichung und stellen keine Beschreibung der Implementierung in einer bestimmten Organisation dar.
Finanzdienstleistungen: ein Vermögensverwaltungs- oder Bankunternehmen
„Connect“ vereint Forschungsergebnisse, Compliance-Leitlinien und Kundenunterlagen in einer einzigen, kontrollierten Quelle, anstatt in drei Systemen, die ein Berater separat durchsuchen muss. „Secure“ bedeutet, dass der Mitarbeiter eines Beraters nur die Kunden dieses Beraters sieht und keine anderen – dies wird bei jeder Abfrage überprüft und nicht lediglich aus einer Rolle abgeleitet. „Anreichern“ bedeutet, genau den einen Absatz mit den zutreffenden Leitlinien zu finden – und nicht die 80-seitige Richtlinie, die ihn umgibt. „Find“ bedeutet, dass sowohl eine Richtliniennummer als auch eine Frage in leicht verständlichem Deutsch korrekt zugeordnet werden. „Ground“ bedeutet, dass Gesprächspunkte aktuelle Forschungsergebnisse und die ihnen zugrunde liegenden Compliance-Richtlinien unter Angabe der jeweiligen Gültigkeitsdaten zitieren. „Deliver“ bedeutet, dass eine Antwort vorliegt, wenn die Aufsicht fragt, was der Berater gesehen hat. Die Aufbewahrungs- und Aufsichtspflichten müssen vom Unternehmen erfüllt werden und gehören zu den Kriterien für Anbieter von Finanzdienstleistungen.
Gesundheitswesen: ein Krankenversicherungsplan
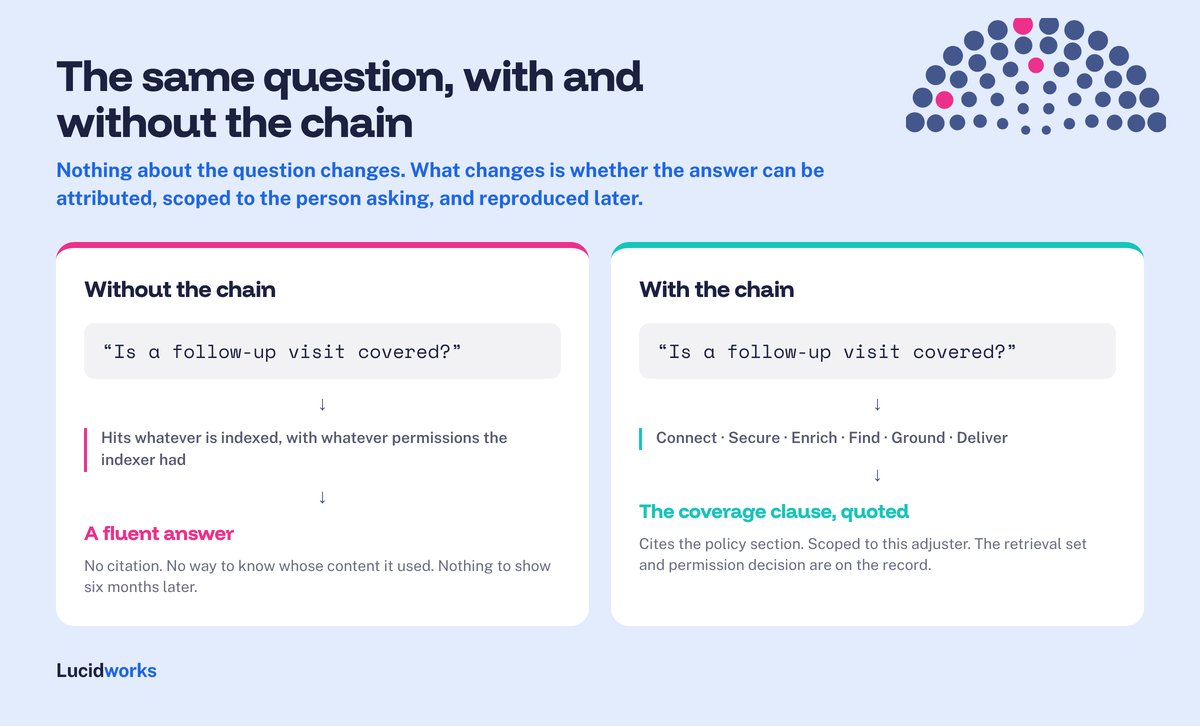
„Connect“ greift auf Versicherungsunterlagen, frühere Entscheidungen und Mitgliederdaten in Systemen zu, die ursprünglich nicht für die Kommunikation untereinander ausgelegt waren. „Secure“ bedeutet, dass der Sachbearbeiter die Daten dieses Mitglieds einsehen kann, nicht jedoch die des nächsten Mitglieds. „Enrich“ bedeutet, die exakte Versicherungsklausel aus einem 300-seitigen Versicherungsdokument zu extrahieren, anstatt das gesamte Dokument zurückzugeben. „Find“ bedeutet, dass sowohl ein Verfahrenscode als auch die Frage „Ist ein Nachsorgetermin abgedeckt?“ den richtigen Abschnitt der Police aufrufen – das deutlichste Beispiel dafür, warum beide Abgleichmethoden zwingend erforderlich sind. „Ground“ bedeutet, dass jede Antwort den entsprechenden Abschnitt der Police sowie die zugrunde liegende Präzedenzentscheidung nennt. „Deliver“ bedeutet, dass die Compliance-Abteilung nachweisen kann, was der Sachbearbeiter gesehen hat – was wiederum eine Überprüfung der Entscheidung ermöglicht. Die Anforderungen an geschützte Gesundheitsdaten gelten für die betroffene Einrichtung und sollten bei jeder Plattform im Rahmen einer Umsetzung im Gesundheitswesen berücksichtigt werden.
Regierung: eine öffentliche Behörde
„Connect“ greift auf Richtlinienhandbücher, Vorschriften und Fallakten dort ab, wo sie sich befinden – einschließlich Systemen, die nicht migriert werden können. „Secure“ bedeutet, dass der Grundsatz „Need-to-know“ gewahrt bleibt und bei jeder Abfrage sowie für jede Person durchgesetzt wird. „Enrich“ bedeutet, den für diesen Fall geltenden Abschnitt der Vorschrift zu finden, nicht die Vorschrift selbst. „Find“ bedeutet, dass sowohl eine Formularnummer als auch eine Frage in einfacher Sprache funktionieren, da die Öffentlichkeit und der Sachbearbeiter in unterschiedlichen Sprachregistern fragen. „Ground“ bedeutet, dass jede Antwort auf das zugrunde liegende Gesetz, die Vorschrift oder die Akte verweist. „Deliver“ bedeutet, dass jede Antwort und jede Maßnahme zur Nachverfolgung protokolliert wird – eine Grundvoraussetzung in der Arbeit des öffentlichen Dienstes und kein zusätzliches Feature. Autorisierungssysteme wie FedRAMP oder StateRAMP sind Anforderungen, denen die Behörde nachkommen muss, und gehören von Anfang an zu den Kriterien für Anbieter.
Lucidworks entwickelt Lösungen direkt für diese Kette. Sein Ansatz, die „AI Context Data Platform“, ist so konzipiert, dass die sechs Schritte als ein einheitlicher, geregelter Prozess ablaufen und nicht als sechs separat beschaffte Tools, wobei die Berechtigungen von der Quelle bis zur Antwort übertragen werden.
Häufig gestellte Fragen
Welchen Schritt lassen Unternehmen am häufigsten aus?
Sicher, da es unsichtbar bleibt, bis es versagt. Die anderen fünf verursachen sichtbare Symptome im Pilotversuch: Fehlende Quellen führen zu unvollständigen Antworten, eine schlechte Chunking-Verteilung liefert unbrauchbare Dokumente, und unbegründete Antworten werden letztendlich aufgedeckt. Ein fehlendes oder nachträglich gefiltertes Berechtigungsmodell liefert Antworten, die perfekt erscheinen, da sie korrekt sind; sie sind jedoch nur korrekt in Bezug auf Inhalte, zu deren Einsicht der Fragesteller keine Berechtigung hatte. Nichts in der Ausgabe deutet auf das Problem hin, sodass es die Pilotphase übersteht.
Können wir diese Schritte mit Werkzeugen durchführen, die wir bereits besitzen?
Zum Teil ja. Die meisten Unternehmen verfügen bereits über Konnektoren, einen Identitätsanbieter, der Gruppenmitgliedschaften verwaltet, eine Suchmaschine sowie Zugriff auf Einbettungsmodelle. Die Schwierigkeit besteht nicht darin, die einzelnen Komponenten zu beschaffen, sondern darin, sie als eine zusammenhängende Kette statt als sechs voneinander getrennte Projekte zum Laufen zu bringen. Berechtigungen müssen den Übergang von der Erfassung zum Abruf überstehen, die Datengrenzen den Übergang zum Ranking und die Herkunftsdaten den Übergang zur Generierung. An diesen Schnittstellen brechen zusammengestellte Systemstacks zusammen.
Handelt es sich hierbei lediglich um RAG mit mehr Schritten?
Die „Retrieval-Augmented Generation“ (RAG) ist eine Möglichkeit, die Schritte vier und fünf umzusetzen. Das Sechs-Schritte-Modell umfasst die Voraussetzungen, die erfüllt sein müssen, damit die Textgewinnung vertrauenswürdig ist, sowie die Schritte nach der Generierung einer Antwort – genau hier scheitern regulierte Implementierungen. Anstatt den gewonnenen Text im Voraus in eine Eingabeaufforderung einzufügen, beziehen Agenten den Kontext zunehmend zur Laufzeit über Tool-Aufrufe, wodurch Berechtigungsprüfungen pro Abfrage und die Protokollierung pro Aufruf nicht an Bedeutung verlieren, sondern vielmehr an Bedeutung gewinnen.
Inwiefern unterscheidet sich eine Kontextschicht von einer semantischen Schicht oder einem Wissensgraphen?
Eine semantische Ebene definiert die geschäftliche Bedeutung strukturierter Daten: Kennzahlen, Dimensionen und Verknüpfungen. Ein Wissensgraph modelliert Entitäten und Beziehungen. Eine Kontext-Ebene ist die übergeordnete Kategorie, die wiederverwendbaren Kontext erstellt, verwaltet und zur Laufzeit an KI-Agenten bereitstellt – in etwa so, wie es Gartner in seinem „Marktüberblick für KI-Kontextplattformen“ vom August 2026 definiert. Der praktische Unterschied liegt in der Reichweite: Semantische Ebenen und Graphen basieren auf strukturierten Quellen, während der Großteil des Unternehmenswissens und nahezu jedes Problem der Zugriffskontrolle in unstrukturierten Inhalten zu finden ist. Forrester definiert die Kontextschicht als die nächste Entwicklungsstufe semantischer Ebenen und Wissensgraphen.
Wie weisen wir einem Prüfer nach, dass eine Antwort fundiert war?
Sie benötigen drei miteinander verknüpfte Datensätze: die Frage und die Identität, unter der sie gestellt wurde, die exakt abgerufenen Textstellen und die zu diesem Zeitpunkt geltenden Berechtigungen sowie die Antwort mit ihren Quellenangaben. Fehlt auch nur einer dieser Datensätze, wird die Rekonstruktion zu einer Vermutung statt zu einem Beweis. Bitten Sie einen Anbieter, dies anhand einer konkreten früheren Abfrage zu demonstrieren, nicht anhand einer neuen: Eine Antwort heute zu reproduzieren ist nicht dasselbe wie zu zeigen, was vor sechs Monaten geschehen ist.
Wo sollen wir anfangen, wenn wir nicht alle sechs Punkte auf einmal umsetzen können?
Beginnen Sie damit, „Connect“ und „Secure“ gemeinsam umzusetzen, und vermeiden Sie es, „Secure“ aufzuschieben. Die nachträgliche Integration von Berechtigungen in ein bereits funktionierendes Abrufsystem bedeutet einen Neuaufbau der Erfassung, da Berechtigungen bereits bei der Erfassung der Inhalte erfasst werden müssen und nicht erst nachträglich hinzugefügt werden dürfen. „Enrich“, „Find“, „Ground“ und „Deliver“ lassen sich auf einer korrekten Grundlage schrittweise verbessern. Die ersten beiden Komponenten können später nicht mehr auf Korrektheit gebracht werden.